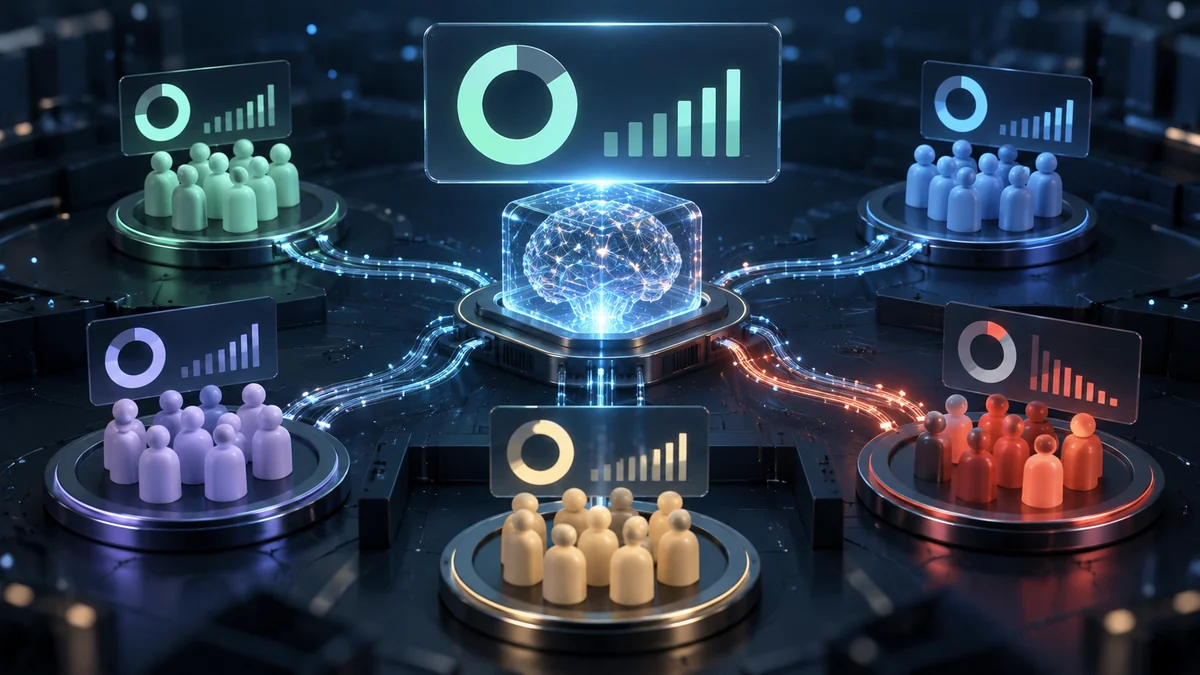
AI 모델의 전체 정확도가 좋아도 특정 설비, 제품, 고객군에서 오류가 집중될 수 있습니다. 평균 하나만 발표하면 현장에선 '우리 경우에는 틀린다'는 불신이 생깁니다. 중요한 집단별 성능을 보고 배포 범위를 결정해야 합니다.
업무상 중요한 집단을 미리 정한다
설비 유형, 제품 크기, 지역, 문서 양식처럼 오류 비용이 다른 구간을 평가 전에 정의합니다. 결과를 보고 유리한 집단만 고르면 문제를 숨기게 됩니다. 집단을 너무 잘게 나누면 표본 부족으로 판단이 불안정해집니다.
정확도와 오류 유형을 함께 본다
불량을 놓치는 미탐과 정상 제품을 막는 오탐은 비용이 다릅니다. 전체 정확도 대신 집단별 재현율, 정밀도, 혼동행렬을 봅니다. 모델 점수의 임계값을 바꿨을 때 각 집단에 어떤 영향이 생기는지도 확인합니다.
표본 수를 반드시 표시한다
한 집단에서 오류가 1건만 늘어도 비율이 크게 출렁일 수 있습니다. 성능표에 사례 수와 불확실성을 붙이고, 희귀 사례는 더 모으거나 전문가 검토로 보완합니다. 관측이 적은 집단을 성능이 검증됐다고 표현하지 않습니다.
운영 데이터의 대표성을 확인한다
평가 데이터가 지난달 주간조만 담았다면 야간조에서 성능을 보장하기 어렵습니다. 시간, 장비, 고객군 분포를 실제 운영과 비교하고 누락된 구간을 시험합니다. 초기 배포는 확인된 범위에서 시작해 점진적으로 확대합니다.
나빠진 집단에 대안을 둔다
전체 평균을 위해 특정 집단의 오류가 커진다면 그 집단만 사람 검수나 이전 모델을 사용할 수 있습니다. 모델 재학습 전 데이터 수집·라벨 기준·입력 품질 문제도 확인합니다. 집단별 오류와 조치 결과를 운영 중 계속 추적합니다.
현장에 적용할 때의 순서
- 중요 집단·오류 비용 정의
- 집단별 지표와 표본 수 확인
- 미검증 구간에 사람 검수
주의할 실패: 전체 평균만으로 전면 배포
관찰할 지표: 집단별 미탐·오탐과 표본 수
적용 전 체크리스트
- 평가 집단을 결과 보기 전에 정했는가
- 집단별 표본 수와 오류 유형을 공개하는가
- 검증되지 않은 집단에 사람 확인 경로가 있는가
참고 자료
scikit-learn classification metrics documentation. 분류 지표의 정의를 참고했습니다. 집단 구분과 배포 결정은 업무 위험과 실제 표본에 따라 정해야 합니다.
이미지와 도식은 이해를 돕기 위한 개념 시각화입니다. 특정 고객의 실제 설비·데이터·화면을 재현한 것이 아닙니다.
#AI평가 #집단별성능 #모델편향 #제조AI #정밀도 #재현율 #모델검증 #데이터대표성 #MLOps #운영AI