어제까지 0.2초였던 고객 목록 조회가 배포 후 8초가 됐습니다. SQL 문장을 비교했는데 달라진 부분이 없습니다. 그래서 서버 수를 늘리려 하지만 원인은 DB가 고른 실행 계획이 바뀐 것일 수 있습니다. 데이터량, 값의 분포, 테이블 통계, 입력 파라미터가 달라지면 옵티마이저는 같은 SQL에도 다른 접근 경로를 선택할 수 있습니다.
쿼리 성능 문제는 ‘문장’이 아니라 ‘특정 입력에서 실제로 실행된 계획’으로 진단해야 합니다. 인덱스가 존재한다는 사실과 그것이 이 경우에 유리하다는 판단도 별개입니다.
먼저 어떤 쿼리가 느려졌는지 고정한다
로그에서 느린 요청 하나를 골라 SQL의 형태, 요청 시각, 테넌트나 데이터 규모, 실제 파라미터 범위, 반환 행 수를 남깁니다. 개인정보와 비밀 값은 기록하지 않습니다. 같은 SQL이라도 ‘최근 하루 자료’와 ‘3년 전체 자료’의 실행 비용은 다릅니다. 평균 지연만 보면 일부 고객의 극단적인 성능 저하를 놓칠 수 있으므로 p95·p99와 조사한 행 수를 함께 봅니다.
DB 연결 대기, 잠금 대기, 디스크 I/O, 쿼리 실행 시간을 분리하는 것도 중요합니다. 앱에서 관측한 8초가 모두 SQL 계산 시간이라는 보장은 없습니다. 실행 계획을 보기 전에 어디에서 시간이 쓰였는지 좁히면 잘못된 인덱스 추가를 피할 수 있습니다.
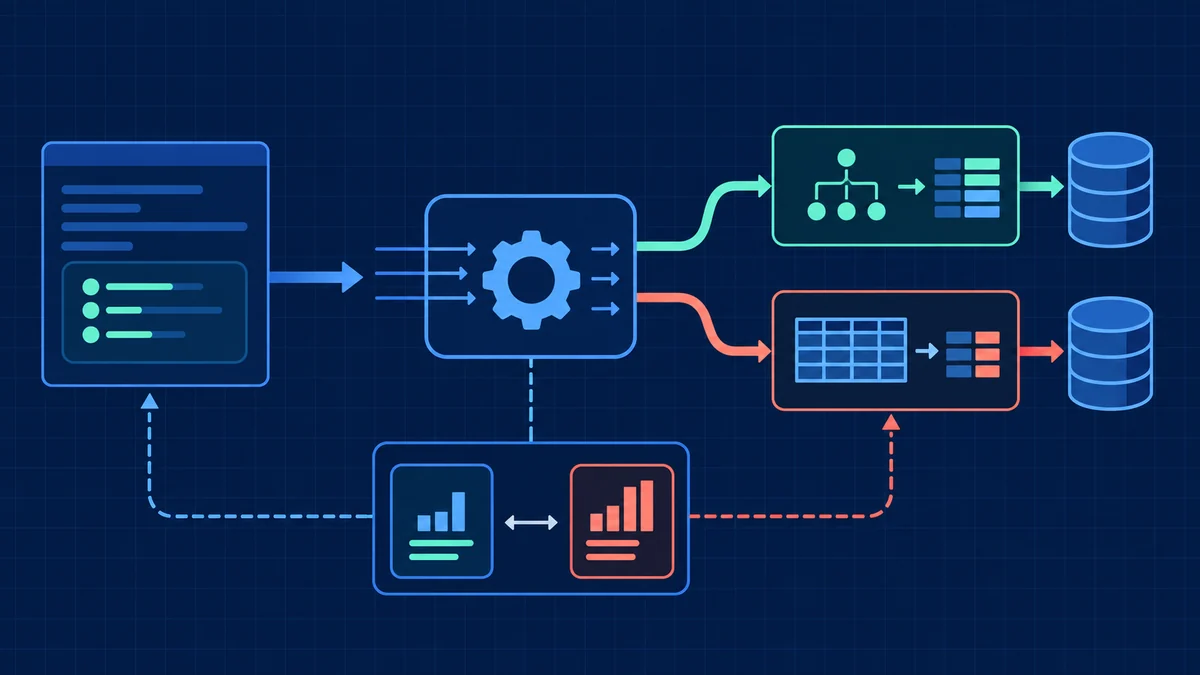
예상 행 수와 실제 행 수를 비교한다
EXPLAIN은 옵티마이저가 선택한 접근 방식과 예상 행 수를 보여줍니다. 예상은 좋은데 실제 실행에서 훨씬 많은 행을 읽었다면 데이터 분포나 통계가 맞지 않을 수 있습니다. MariaDB의 ANALYZE와 EXPLAIN 문서는 계획 분석 도구를 정리합니다. 실제 실행을 수반하는 분석 명령은 운영 환경에서 큰 쿼리에 무심코 실행하지 말고 부하와 권한을 확인한 뒤 사용해야 합니다.
정렬, 임시 테이블, 조인 순서, 선택한 인덱스, 필터 적용 위치를 비교합니다. 선택도가 낮은 조건에 인덱스를 써도 많은 행을 읽을 수 있고, 적절한 복합 인덱스가 있어도 조건 순서나 표현식 때문에 활용하지 못할 수 있습니다. 문제는 ‘인덱스가 없다’로 단정하기 전에 계획에서 확인해야 합니다.
통계 갱신은 해결책이자 변경이다
데이터가 빠르게 늘거나 특정 고객의 값이 쏠리면 옵티마이저의 추정이 실제와 벌어질 수 있습니다. MariaDB의 ANALYZE TABLE 문서는 테이블·인덱스 통계가 실행 계획 선택에 쓰이는 과정을 설명합니다. 다만 통계 갱신은 계획을 바꿀 수 있으므로 대형 테이블과 바쁜 시간대에는 실행 비용과 영향을 검토해야 합니다. 특정 쿼리 하나만 빨라지고 다른 쿼리가 느려질 가능성도 살핍니다.
애플리케이션 변경도 원인일 수 있습니다. 기존에는 제한된 페이지 크기만 조회했는데 화면에서 무제한 다운로드를 요청하거나, 필터가 선택적으로 적용되어 조건이 느슨해졌을 수 있습니다. DB 버전, 스키마, 인덱스, 통계, 파라미터, 실제 데이터 규모를 같이 비교해야 ‘SQL은 같은데 왜 느린가’에 답할 수 있습니다.
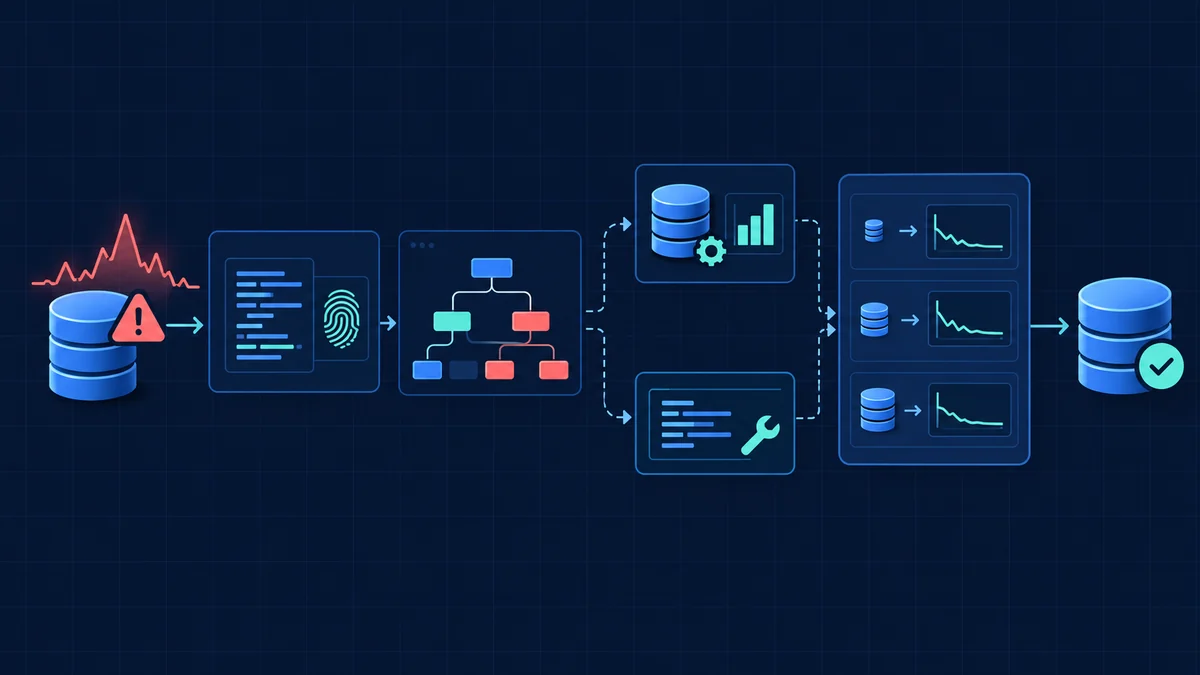
수정안을 다양한 입력으로 검증한다
한 고객의 작은 데이터셋에서 빨라진 쿼리가 대형 고객에게는 더 느릴 수 있습니다. 작은·보통·큰 테넌트, 흔한 값·드문 값, 짧은·긴 기간을 골라 실행 시간과 읽은 행 수를 비교합니다. 수정안이 조인 결과나 정렬 순서를 바꾸지 않는지도 확인합니다. 배포 후에는 동일한 SQL 형태의 지연·행 수·오류율을 관찰하고, 악화되면 되돌릴 수 있는 경로를 준비합니다.
진단 체크리스트
- 느려진 요청의 SQL 형태와 입력 범위를 확인한다.
- 연결·잠금·실제 실행 시간을 분리한다.
- 예상 행 수와 실제 읽은 행 수를 비교한다.
- 통계·인덱스·데이터 분포·앱 요청 변화를 함께 본다.
- 대표 파라미터 여러 개로 수정안과 회귀를 시험한다.
DB 성능 개선은 인덱스를 무조건 늘리는 작업이 아닙니다. 실제 데이터에서 어떤 계획이 왜 선택됐고, 그 선택이 어느 입력에서 나빠지는지를 설명할 수 있어야 안전하게 고칠 수 있습니다.
#DB실행계획 #쿼리회귀 #느린쿼리 #MariaDB #EXPLAIN #ANALYZE #데이터베이스성능 #백엔드개발 #쿼리최적화 #관측성