유전 알고리즘 결과를 재현 가능하게 만드는 법
유전 알고리즘은 무작위 선택과 돌연변이를 사용합니다. 같은 코드라도 실행마다 다른 결과가 나오므로 ‘좋은 해를 한 번 찾았다’는 사실만으로 품질을 판단하기 어렵습니다. 실험을 재현할 수 있는 기록과 반복 측정이 필요합니다.
시드만 기록해서는 부족하다
난수 시드뿐 아니라 입력 데이터 버전, 목적함수, 염색체 표현, 집단 크기, 교차·돌연변이 확률, 종료 조건을 기록합니다. 병렬 실행은 난수 사용 순서를 바꿀 수 있으므로 실행 환경도 남깁니다.
한 번의 최고값보다 분포를 본다
같은 문제를 여러 시드로 실행해 최선·중앙값·나쁜 쪽 결과와 계산 시간을 비교합니다. 한 번의 운 좋은 실행만 보고하면 현장에서 반복했을 때 예상보다 나쁜 배치가 나올 수 있습니다.
유효 해를 따로 확인한다
비용이 낮아도 선후관계, 인력 자격, 용량 제약을 위반하면 실행할 수 없습니다. 디코더와 평가 함수 외에 독립 검증기로 최종 해를 다시 점검해야 합니다.
작은 문제의 최적값과 대조한다
소규모 사례를 MILP나 CP-SAT으로 풀어 정답을 확보하면 GA의 표현·평가 버그를 찾기 쉽습니다. 큰 문제에서는 최적을 보장한다고 주장하지 말고 하한과 실행 시간 대비 품질을 보고합니다.
실험 결과를 묶어 보관한다
각 실행의 시드와 로그, 최종 배치, 제약 위반 결과를 저장합니다. 파라미터를 바꾼 뒤 개선됐다고 말하려면 동일한 문제 세트와 비슷한 계산 예산에서 비교해야 합니다.
현장에 적용할 때의 순서
- 입력·시드·파라미터·코드 버전 저장
- 반복 실행의 비용·시간 분포 측정
- 최종 해를 제약 검증기로 확인
주의할 실패: 최고 결과 한 번만 보고 성능 주장
관찰할 지표: 시드별 비용 분산·유효 해 비율·실행 시간
적용 전 체크리스트
- 시드·데이터·코드·파라미터 버전을 남긴다
- 여러 시드의 결과 분포를 비교한다
- 최종 해를 독립 검증기로 재검사한다
참고 자료
Moon et al. (2014), Integrated Assembly Line Balancing with Skilled and Unskilled Workers. 랜덤 키 유전 알고리즘을 사용한 회사 연구자의 공개 논문을 참고했습니다. 시드·실험 기록과 독립 검증은 재현성 확보를 위한 적용 제안입니다.
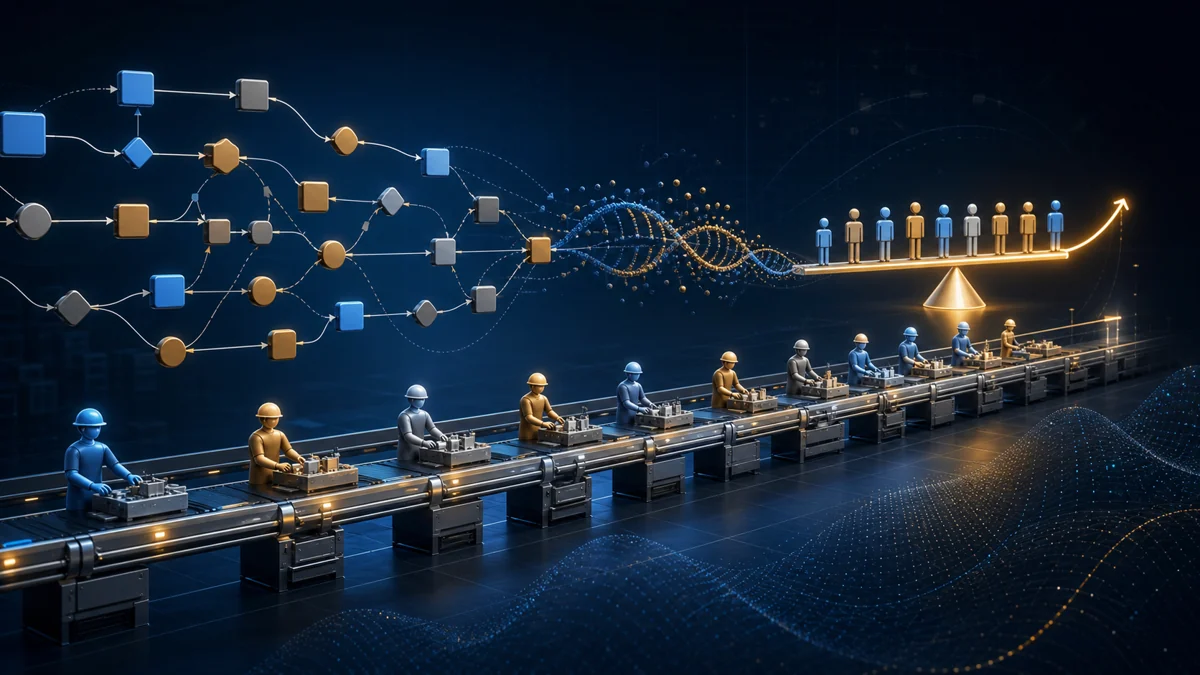
이미지와 도식은 이해를 돕기 위한 개념 시각화입니다. 특정 고객의 실제 설비·데이터·화면을 재현한 것이 아닙니다.
#유전알고리즘 #GA #재현성 #무작위시드 #메타휴리스틱 #최적화 #실험설계 #유효해 #MILP #스케줄링
이 주제를 실제 시스템으로 옮기려면 AI 알고리즘 개발 살펴보기