검사 AI의 내부 시험 성적은 좋았는데 다른 생산라인에 설치하자 오검출이 늘었습니다. 모델 구조가 나빠서일 수도 있지만 먼저 확인할 것은 평가 데이터를 어떻게 나눴는가입니다. 같은 부품을 연속 촬영한 수백 장, 같은 카메라와 조명에서 나온 이미지, 동일한 생산 로트의 표면 무늬가 학습과 시험에 섞여 있으면 모델은 불량의 본질보다 익숙한 배경과 설비 특성을 기억할 수 있습니다. 시험 점수가 좋아 보여도 낯선 날짜나 설비에서는 통하지 않습니다.
무작위 이미지 분할은 독립 표본을 보장하지 않는다
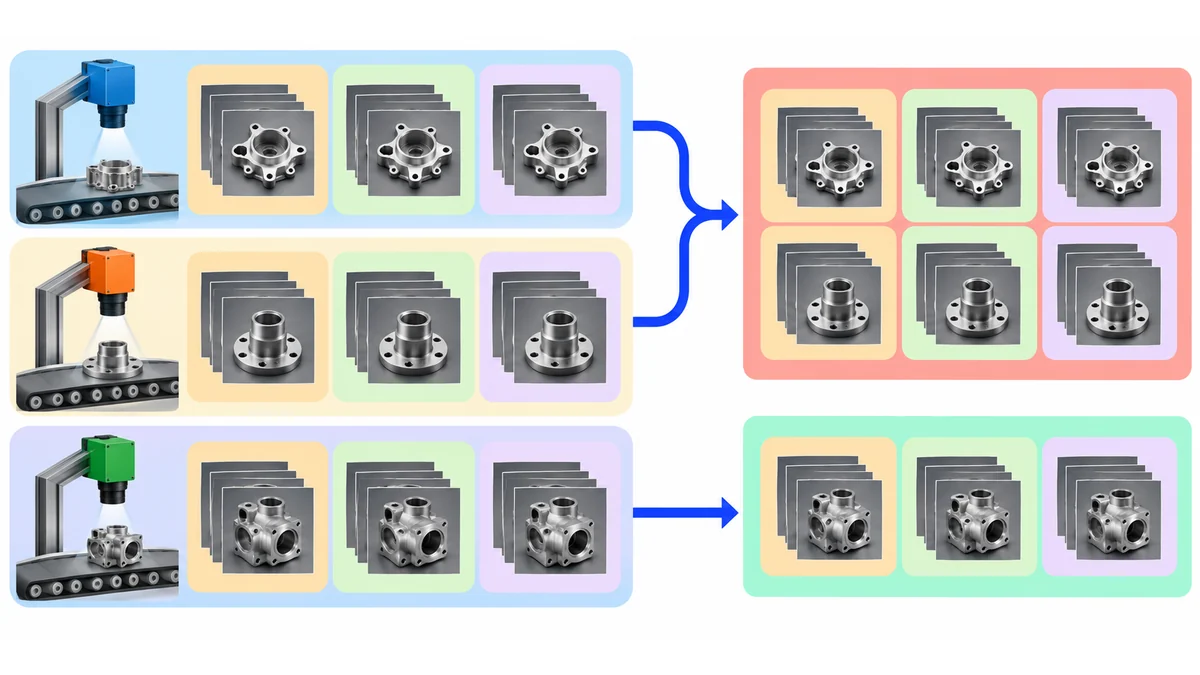
웹에서 모은 서로 다른 사진과 달리 제조 데이터는 시간과 설비를 따라 강하게 연결됩니다. 하나의 불량 부품을 여러 각도에서 찍은 이미지, 같은 원본에서 잘라낸 패치, 연속 프레임은 사실상 한 사건의 변형입니다. 이것을 이미지 단위로 무작위 분할하면 비슷한 장면이 양쪽에 들어갑니다. 데이터가 많아 보여도 독립적인 사례 수는 훨씬 적을 수 있습니다. 먼저 이미지마다 설비 ID, 촬영 시각, 생산 로트, 제품 모델, 원본 프레임, 재작업 여부를 연결해 두어야 합니다. 이런 메타데이터가 없으면 올바른 평가 집합 자체를 만들기 어렵습니다.
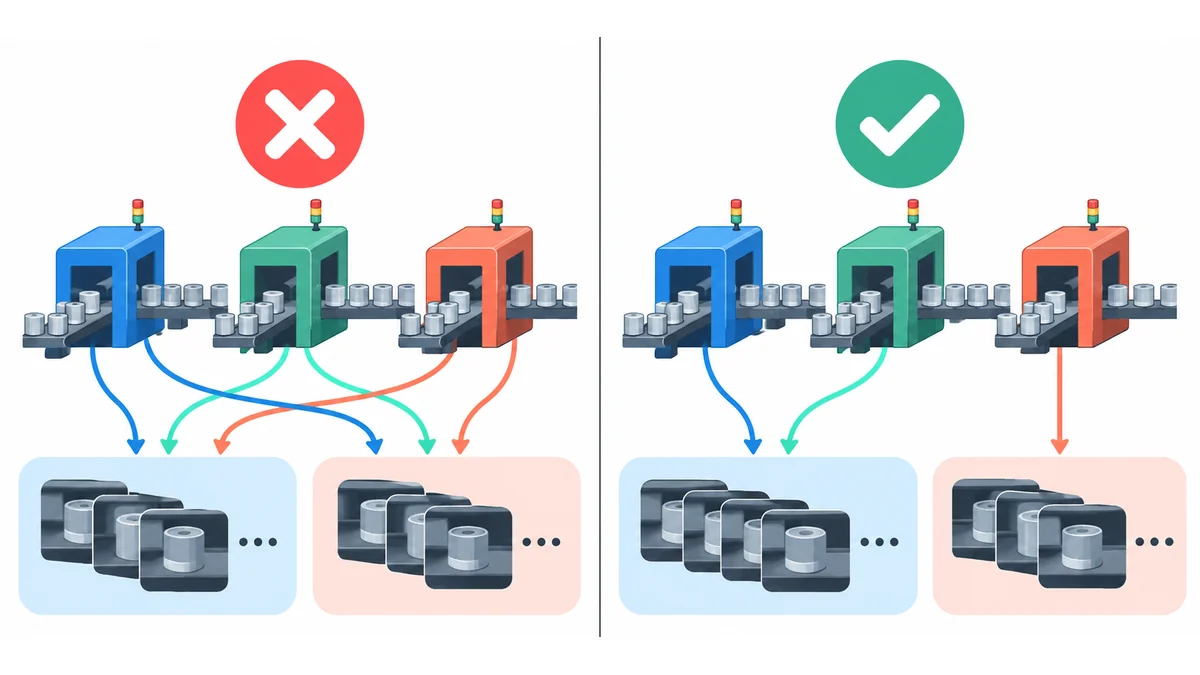
분할 단위는 배포 시 맞닥뜨릴 ‘새로움’에 맞춰 정합니다. 같은 라인에서 내일 촬영할 제품을 예측한다면 날짜나 로트를 기준으로 미래 구간을 남겨 둡니다. 새로운 공장이나 카메라로 확장할 계획이라면 특정 설비를 통째로 시험 집합에 남깁니다. 모델을 다른 제품 모델에도 적용할 것이라면 제품 모델 단위 검증이 필요할 수 있습니다. 하나의 점수로 이 모든 일반화 능력을 증명할 수는 없습니다. scikit-learn의 GroupKFold는 같은 그룹이 학습·시험 폴드에 동시에 들어가지 않게 하는 도구입니다. 실제 운영에서는 그룹과 시간 조건을 함께 설계해야 합니다.
전처리에서도 시험 정보가 새어 나간다
평균과 표준편차를 계산하거나 특징을 고르는 단계에서 시험 데이터까지 사용하면 모델이 시험 집합의 통계를 미리 본 셈입니다. 이미지 밝기를 맞추는 기준, 결측값 보정, 불량 패턴을 이용한 특징 선택도 학습 데이터만으로 결정하고 시험 데이터에는 같은 변환만 적용합니다. 유사 이미지 제거와 증강 순서도 중요합니다. 한 원본에서 만든 증강 이미지를 먼저 쌓은 뒤 나누면 양쪽이 거의 동일해질 수 있습니다. 먼저 원본 사건을 묶어 분할하고, 증강은 학습 집합 내부에서만 만드세요. scikit-learn의 데이터 누수 지침도 시험 데이터가 모델 구성에 사용되면 평가가 낙관적으로 치우친다고 설명합니다.
성적표에는 전체 정확도 하나보다 현장에서 중요한 실패를 나눠 보여 줘야 합니다. 불량을 놓친 비율, 정상 제품을 불량으로 잡은 비율, 제품 모델·카메라·조명·교대조별 성능을 확인합니다. 불량이 드문 공정이라면 정확도만으로는 놓친 불량을 가릴 수 있습니다. 어떤 구간에서 검출 성능이 무너지는지 찾으면 데이터 추가 수집이나 조명 개선의 우선순위도 보입니다. 평가 집합의 출처와 분할 규칙, 중복 제거 기준은 모델 버전과 함께 보존해야 같은 주장을 다시 검증할 수 있습니다.
분할 결과에는 각 집합의 정상·불량 건수뿐 아니라 설비별, 로트별 건수도 함께 적습니다. 어떤 로트에는 불량이 하나도 없다면 점수 차이가 모델 때문인지 표본 구성 때문인지 구분하기 어렵습니다. 시험 집합을 구성할 때 현장 전문가와 함께 새로운 설비·조명·재질의 비중을 확인하고, 표본이 부족한 구간은 불확실하다고 명시하는 편이 과장된 평균 점수보다 유용합니다.
현장 투입 전에 확인할 질문
첫째, 같은 물리적 부품이나 원본 프레임이 학습과 시험에 동시에 있는가? 둘째, 앞으로 설치할 설비와 시험 설비가 같은가? 셋째, 시험 집합을 보며 임계값과 모델을 반복해서 고르지는 않았는가? 넷째, 새로운 날짜와 로트의 결과를 따로 보고 있는가? 마지막 질문이 특히 중요합니다. 여러 번 선택에 사용한 시험 집합은 사실상 검증 집합이 되므로 최종 판단용 별도 데이터가 필요합니다. AI 검사의 신뢰는 높은 숫자 자체가 아니라, 그 숫자가 어떤 새로운 현장을 대표하는지 설명할 수 있는 분할에서 시작합니다.