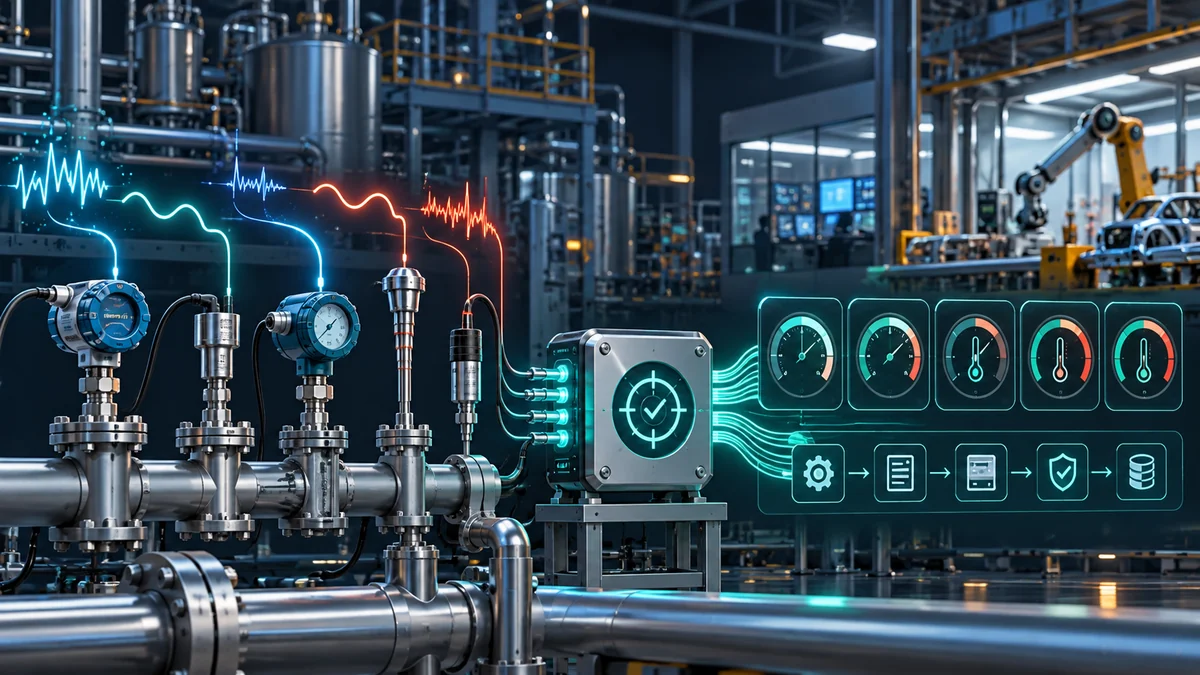
두 공장의 압력 센서를 같은 그래프에 올렸습니다. 한쪽 값은 100, 다른 쪽은 1로 보입니다. 얼핏 한 공장의 압력이 백 배 높아 보이지만, 실제로는 표시 단위와 스케일이 다를 수 있습니다. 숫자만 수집해 AI 모델에 넣으면 데이터는 정상적으로 흐르는 듯해도 판단은 틀립니다. 산업 데이터 플랫폼의 첫 번째 과제는 값의 개수가 아니라 그 값이 무엇을 어떤 조건에서 측정했는지를 보존하는 것입니다.
태그 이름만으로 의미를 알 수 없다
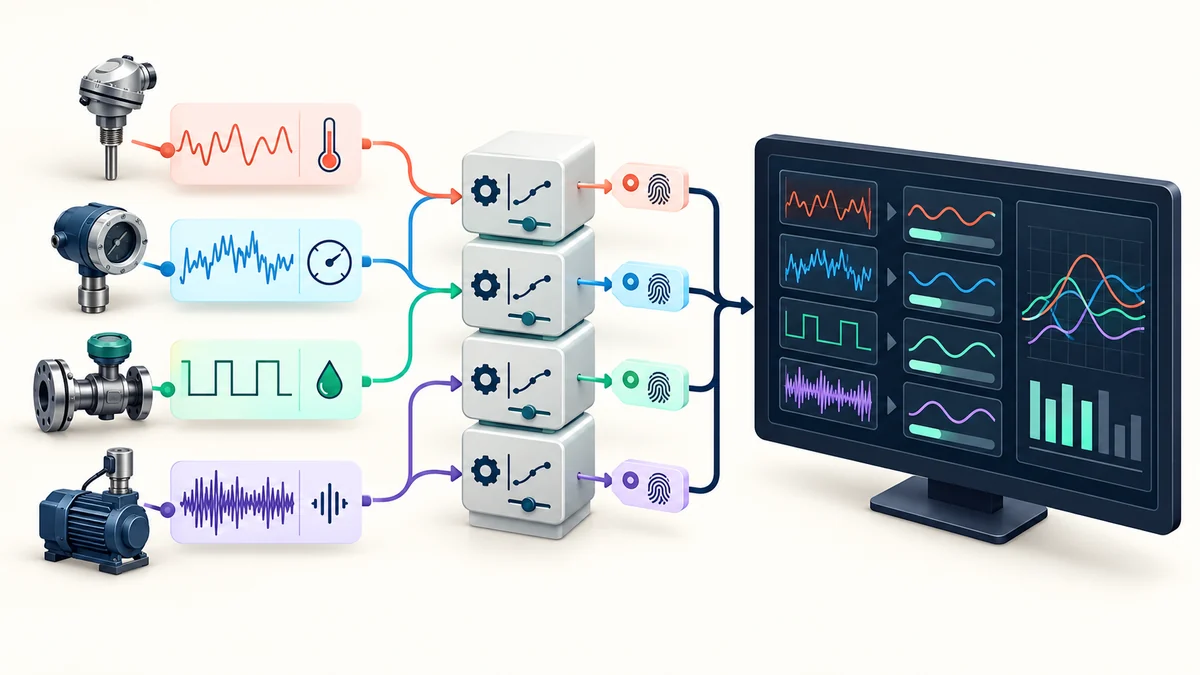
PLC나 설비 서버의 태그 이름은 현장마다 다릅니다. P01이라는 이름이 압력인지, 펌프 상태인지 외부 시스템은 알 수 없습니다. 같은 이름을 다른 설비에서 재사용할 수도 있습니다. 측정 지점에는 설비 ID, 센서 ID, 측정 대상, 공학 단위, 허용 범위, 장비 범위, 샘플링 주기, 품질 상태를 연결해야 합니다. 화면에 보여줄 소수점 자리수와 원본 정밀도도 구분하세요. 보기 좋게 반올림한 값을 다시 계산에 쓰면 작은 변화가 사라집니다.
온도는 섭씨와 화씨, 압력은 절대압과 게이지압처럼 단위 표기만 같아도 기준이 다를 수 있습니다. 전류 신호를 공학 값으로 바꾸는 스케일도 장비 설정에 따라 달라집니다. 따라서 ‘모든 숫자에 100을 곱한다’ 같은 코드 규칙은 위험합니다. 태그별 변환 공식과 유효 기간을 데이터로 관리하고, 설비 교체 시에는 새 규칙이 언제부터 적용됐는지 기록해야 합니다.
원본과 정규화 값을 모두 남긴다
수집 시점에 원본값을 버리고 표준 단위 값만 저장하면 나중에 변환 오류를 고치기 어렵습니다. 원본값·원본 단위·원본 시각과 함께 정규화 값·표준 단위·변환 규칙 버전·변환 시각을 별도로 저장하세요. 이후 보정 값이 잘못됐다는 사실을 알았을 때 어느 기간의 데이터를 다시 계산해야 하는지 알 수 있습니다. 과거 데이터를 재처리할 때는 기존 분석 결과의 버전도 남겨야 보고서 숫자가 왜 바뀌었는지 설명할 수 있습니다.
수집 파이프라인은 변환이 실패한 값을 조용히 0으로 바꾸지 않아야 합니다. 단위가 없거나 변환 규칙이 모호하면 격리 상태로 보내고 운영자가 확인하게 합니다. 센서가 끊긴 상태의 마지막 값을 계속 보내는 설비도 있으므로 ‘값이 들어왔다’와 ‘새롭고 유효한 값이다’를 구분합니다. 품질 플래그가 나쁜 값은 대시보드에서는 주의 상태로 보여주고, 자동 제어 또는 AI 학습에서는 별도 기준으로 제외할 수 있습니다.
보정은 장비의 이력이다
센서는 사용하면서 오차가 생길 수 있어 주기적으로 보정합니다. 보정 결과를 종이 성적서로만 보관하면 시계열 데이터와 연결하기 어렵습니다. 보정 전후 계수, 기준 장비, 담당자, 승인, 적용 시작 시각을 센서 ID에 연결하세요. 보정이 지연됐다고 지난 데이터 전체가 무효라는 뜻은 아닙니다. 다만 해당 기간의 신뢰 수준을 표시하고 중요한 품질 판단에는 검토 절차를 둬야 합니다.
표준 단위를 정할 때는 단위 변환 외에도 범위와 분해능을 확인합니다. 낮은 해상도의 센서 값을 정밀한 실수처럼 표시하면 거짓 정밀도가 생깁니다. 설비가 바뀌었는데 태그 이름만 유지됐다면 이전 값과 이후 값을 하나의 연속 추세로 이어도 되는지 검토해야 합니다. 데이터 카탈로그에 단위뿐 아니라 의미의 변경 기록을 남기는 이유입니다.
작은 검증 세트로 시작한다
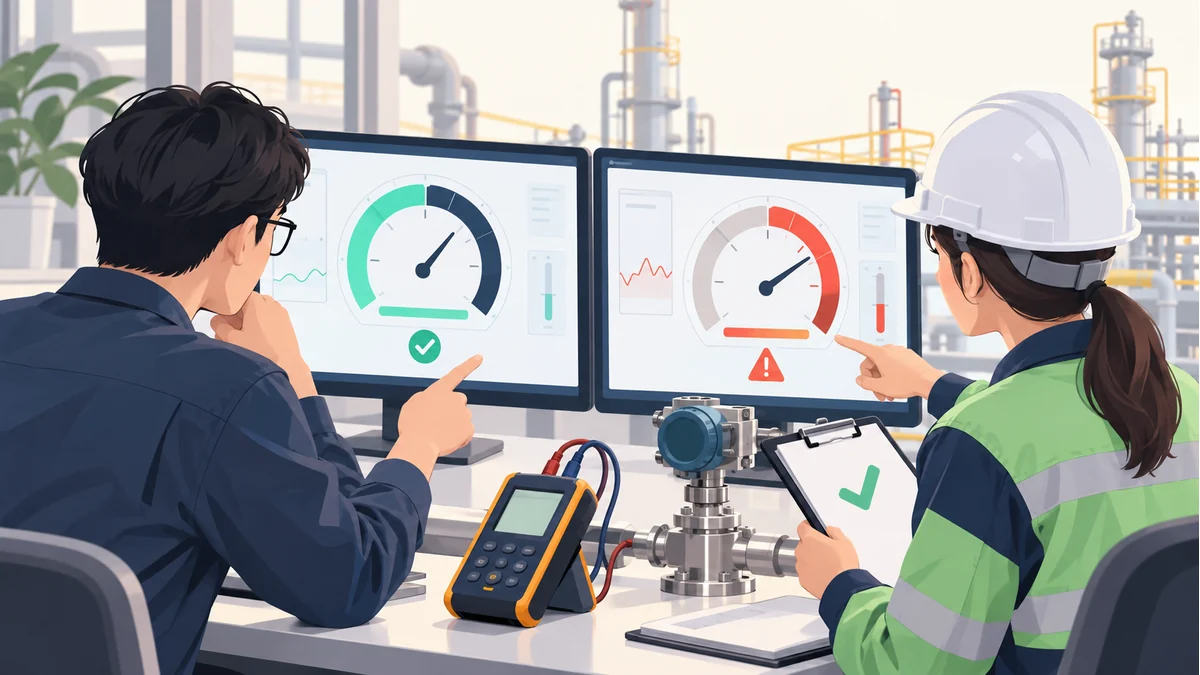
압력·온도·전류처럼 대표적인 측정 지점 몇 개를 골라 현장 계기의 표시와 수집 원본, 정규화 결과를 같은 시각에 비교하세요. 정상 범위 상단과 하단, 센서 단선, 장비 교체, 보정 직후 사례까지 시험합니다. 담당자가 확인한 변환 규칙만 배포하고, 예상 범위를 벗어나는 값이 급증하면 알림을 보냅니다. 이 과정에서 운영팀과 데이터팀이 서로 다른 ‘정상’의 정의를 쓰고 있었다는 사실을 자주 발견합니다.
OPC UA for Machinery의 공정 값 예시는 측정값과 EngineeringUnits, 범위 같은 맥락 정보를 함께 표현합니다. 표준을 채택하든 기존 인터페이스를 개선하든 원칙은 같습니다. 센서 숫자만 이동시키지 말고 단위, 보정, 품질 상태를 같이 이동시켜야 비교와 AI 판단이 안전해집니다.