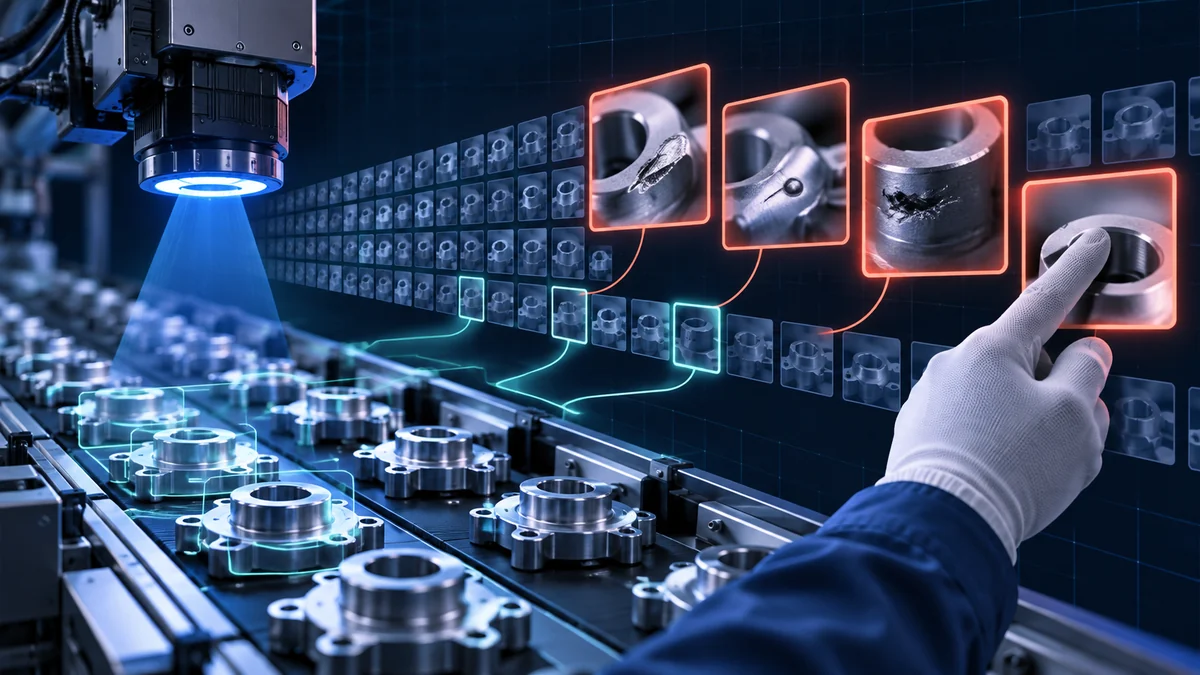
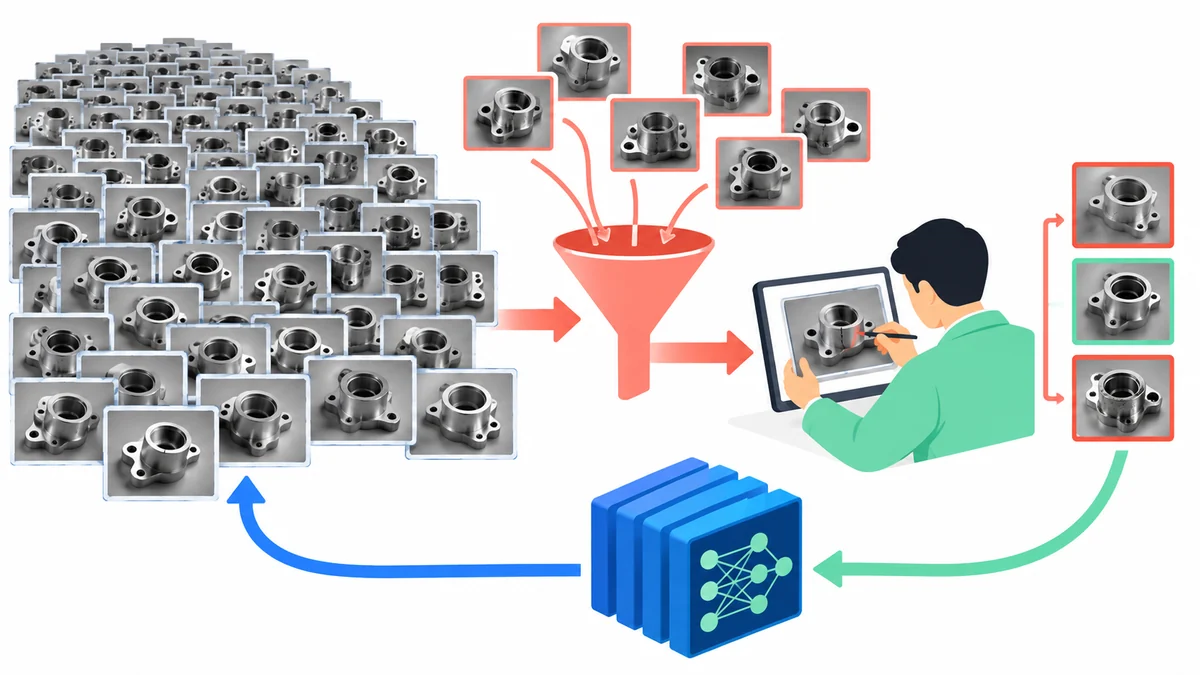
공장 카메라가 하루 종일 제품을 촬영하면 이미지가 빠르게 쌓입니다. 사람에게 모든 사진을 정상·불량으로 분류해 달라고 부탁하면 비용과 피로가 늘어납니다. 그렇다고 무작위로 몇 장만 고르면 실제로 모델이 어려워하는 긁힘, 조명 변화, 낯선 제품 모델이 빠질 수 있습니다. 액티브러닝은 이미 학습한 모델이 어떤 미라벨 데이터의 정답을 물어볼지 골라 전문가에게 제안하고, 확인된 답을 다음 학습에 사용하는 방식입니다. 핵심은 자동 라벨링이 아니라 사람의 판단을 필요한 곳에 집중시키는 것입니다.
‘모델이 헷갈린다’만으로 선택하면 부족하다
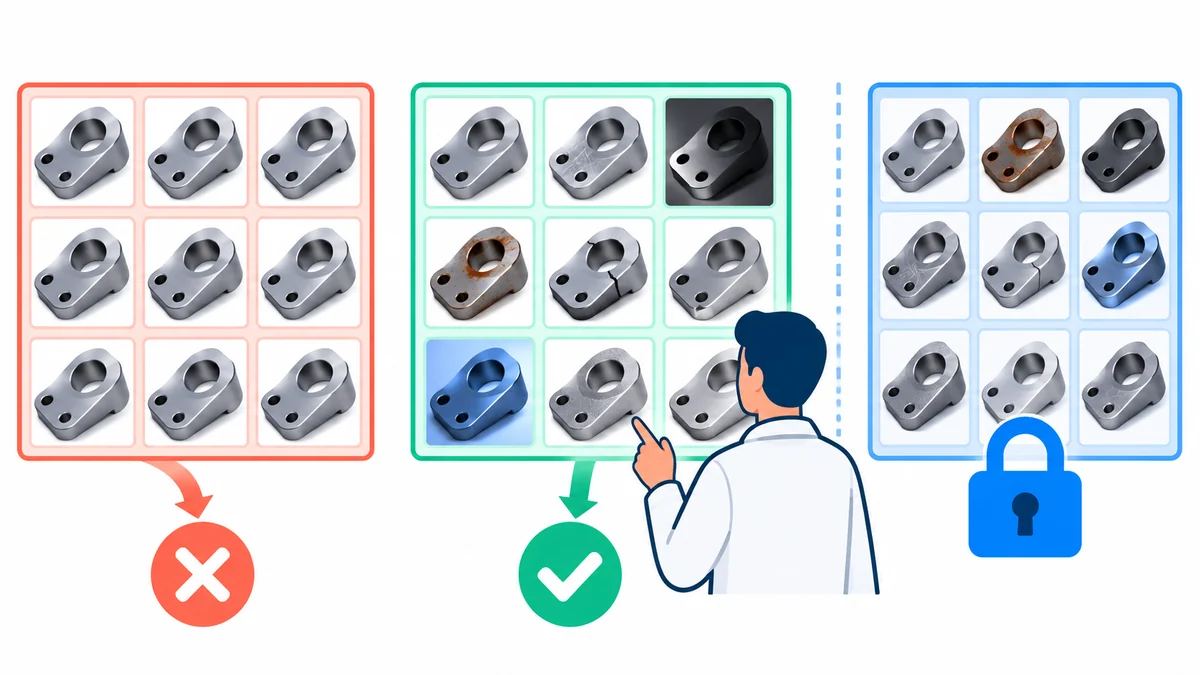
대표적인 선택 기준은 불확실성입니다. 모델의 정상·불량 점수가 비슷하거나 여러 모델의 판단이 갈리는 이미지는 사람이 확인할 가치가 있을 수 있습니다. 그러나 같은 부품을 연속 촬영한 거의 동일한 프레임 수백 장이 모두 불확실하다면 그중 수백 장을 라벨링해도 새로운 정보는 적습니다. 중복 제거, 설비·날짜·제품 모델의 균형, 시각적 특징의 다양성을 함께 고려해야 합니다. 장비 이상으로 새까맣게 찍힌 사진처럼 정보가 없는 샘플도 ‘불확실’하게 나올 수 있으니 촬영 실패와 실제 어려운 결함을 구분합니다.
처음부터 자동 선택 점수 하나로 업무를 결정하지 마세요. 예를 들어 후보를 ‘모델이 확신하지 못한 것’, ‘기존 데이터와 다른 것’, ‘현장 규칙상 중요한 것’으로 나눠 검토 큐에 올릴 수 있습니다. 희귀하지만 고객에게 큰 영향을 주는 결함은 빈도와 상관없이 별도 우선순위를 줍니다. 모델의 점수는 실제 확률과 다를 수 있으므로 확신도의 보정 상태도 확인해야 합니다. 제조 시각 검사 액티브러닝 연구도 사람의 확인과 모델의 선택·보정 문제를 함께 다룹니다.
라벨러에게 보여 주는 화면이 성능을 좌우한다
현장 전문가는 이미지 한 장만으로 정상인지 판단하기 어려울 수 있습니다. 같은 제품의 정상 참고 이미지, 촬영 설비, 조명 상태, 이전 공정 기록을 함께 보여 주되 모델의 예상 정답을 먼저 크게 노출하면 사람 판단이 끌려갈 수 있습니다. 처음에는 독립 판단을 받고, 필요할 때 모델 제안과 근거를 비교하는 절차가 유용합니다. 애매한 결함은 단일 정답을 강요하지 않고 ‘판정 보류’, ‘추가 촬영 필요’, ‘품질팀 확인’ 상태로 보냅니다. 사람마다 판정이 갈리면 라벨링 지침을 수정하고 합의 내용을 버전으로 남깁니다.
선택된 이미지는 원본 식별자와 생산 로트를 붙여 저장합니다. 같은 물리적 부품의 여러 사진이 학습과 최종 시험에 섞이면 성능이 부풀려질 수 있으므로 시험 집합은 액티브러닝 선택 과정에서 건드리지 않도록 잠급니다. 모델을 새로 학습할 때마다 기존 라벨을 무조건 다시 믿기보다 기준 변경이나 재촬영으로 무효해진 라벨이 있는지도 확인합니다. 유사 이미지 묶음에서 대표 사진만 묻더라도 나머지 사진의 정답을 기계적으로 복사하면 다른 각도에서 드러나는 결함을 놓칠 수 있습니다.
검수 예산이 일정하다면 하루에 어떤 설비와 결함 유형에서 몇 건을 받을지 상한을 둡니다. 특정 조명 문제로 발생한 이미지가 큐를 모두 차지하면 다른 라인의 새로운 불량은 계속 뒤로 밀립니다. 후보 점수와 함께 선택 사유를 보여 주고, 전문가가 ‘이미 알고 있는 유형’이나 ‘촬영 오류’로 반려할 수 있게 하면 다음 선택 라운드의 품질도 좋아집니다. 반려 사유는 모델 오류와 데이터 수집 문제를 구분하는 단서가 됩니다.
라벨 수가 아니라 개선된 결정으로 평가한다
이번 주에 몇 장을 라벨링했는지는 활동량일 뿐 성과가 아닙니다. 현장에서 불량을 놓친 비율, 정상 제품을 잘못 걸러낸 비율, 전문가가 재검토한 시간, 새로운 설비에서의 성능을 같은 기준으로 비교해야 합니다. 무작위 샘플링과 액티브러닝을 같은 라벨링 예산으로 비교하면 선택 전략의 효과를 더 정확히 볼 수 있습니다. 모델이 자신 없는 곳만 계속 묻다 보면 쉬운 정상 사례의 비율 변화도 놓칠 수 있으므로 일부 무작위 표본을 유지하는 편이 좋습니다. 액티브러닝은 ‘사람을 빼는 기술’이 아니라 전문가의 판단을 다음 모델 개선에 가장 잘 연결하는 운영 구조입니다.