게시글 제목은 정상인데 본문만 ‘??’로 보이거나, 관리자 카테고리 이름까지 물음표로 바뀌는 일이 있습니다. 이때 CSS나 폰트를 먼저 바꿔도 해결되지 않을 수 있습니다. 저장된 값이 이미 물음표로 바뀌었다면 화면은 잃어버린 글자를 되살릴 수 없습니다. 문제를 빨리 좁히려면 브라우저에서 DB까지 이어지는 문자 데이터의 경계를 나눠 봐야 합니다.
문자, 바이트, 표시를 구분한다
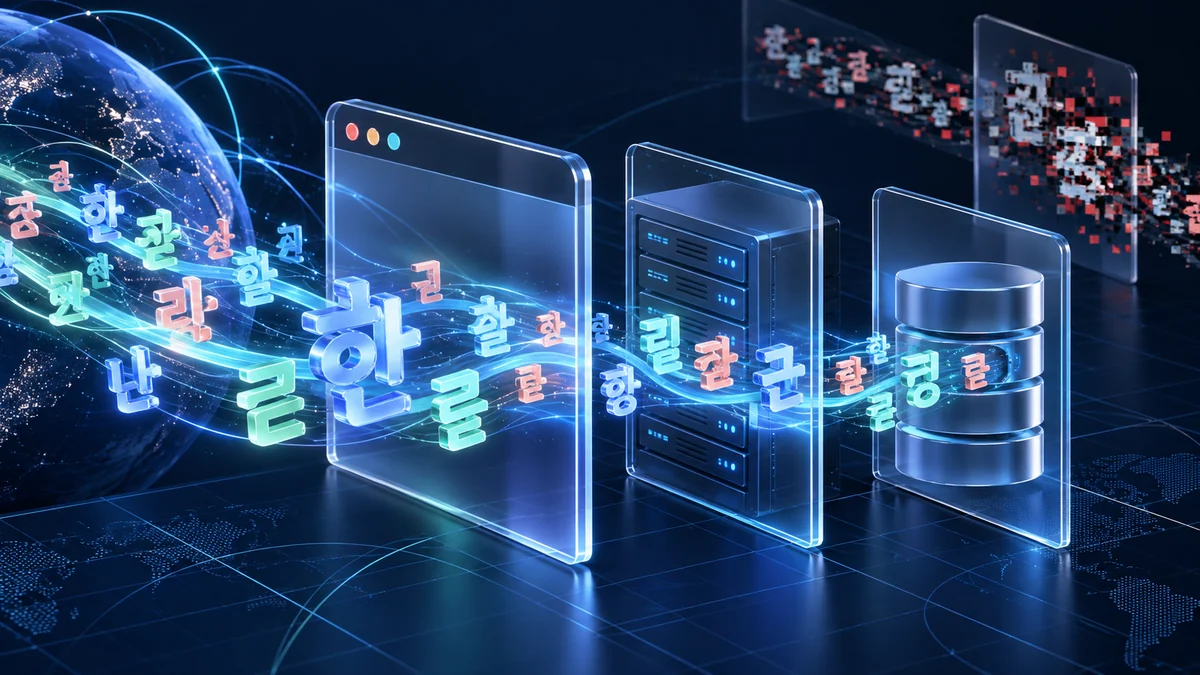
‘한’이라는 문자는 메모리와 파일, 네트워크에서 바이트로 표현됩니다. 인코딩은 문자와 바이트를 대응시키는 규칙입니다. 서버가 UTF-8로 보낸 바이트를 브라우저가 다른 규칙으로 읽으면 다른 글자로 보일 수 있습니다. 반면 처음부터 변환 과정에서 표현할 수 없는 문자가 ‘?’로 대체돼 DB에 저장됐다면 응답 헤더만 고쳐서는 복구되지 않습니다. W3C의 문자 인코딩 안내는 웹 콘텐츠에 UTF-8을 사용하고 실제 저장 방식과 선언을 맞추라고 권합니다.
또 하나 혼동하기 쉬운 경우는 폰트가 글리프를 갖고 있지 않아 네모 상자로 보이는 현상입니다. 이때 원본 문자열을 복사하면 한글이 살아 있을 수 있습니다. 반대로 복사해도 ‘??’라면 문자열 자체가 손상됐을 가능성이 큽니다. 진단할 때는 먼저 페이지 원본, 네트워크 응답, DB 원본을 각각 확인합니다.
어느 지점에서 처음 깨졌는지 찾는다
작은 테스트 문자열을 준비합니다. 한글, 영문, 숫자, 이모지, 따옴표를 섞되 운영 데이터가 아닌 테스트 환경에서 사용합니다. 폼 입력 직후, API 요청 본문, 서버가 파싱한 값, DB 저장값, API 응답, 최종 화면을 순서대로 비교합니다. 처음 다른 값이 나타나는 경계가 문제 지점입니다. 로그에는 개인정보를 그대로 남기지 말고 테스트 ID와 길이·해시 또는 안전한 샘플만 기록합니다.
DB의 테이블 문자셋뿐 아니라 연결 세션의 문자셋도 봐야 합니다. 프로그램이 보내는 문자열과 연결 드라이버가 기대하는 인코딩이 다르면 DB 컬럼이 UTF-8이어도 저장 전에 손실될 수 있습니다. CSV나 배치 스크립트로 데이터를 넣는 경로는 웹 요청 경로와 별도로 확인합니다. 특히 Windows 셸의 기본 문자 인코딩은 작업 방식에 따라 달라질 수 있으므로 파일 읽기·쓰기 시 인코딩을 명시하고, 테스트 행을 실제로 다시 읽어 검증합니다.
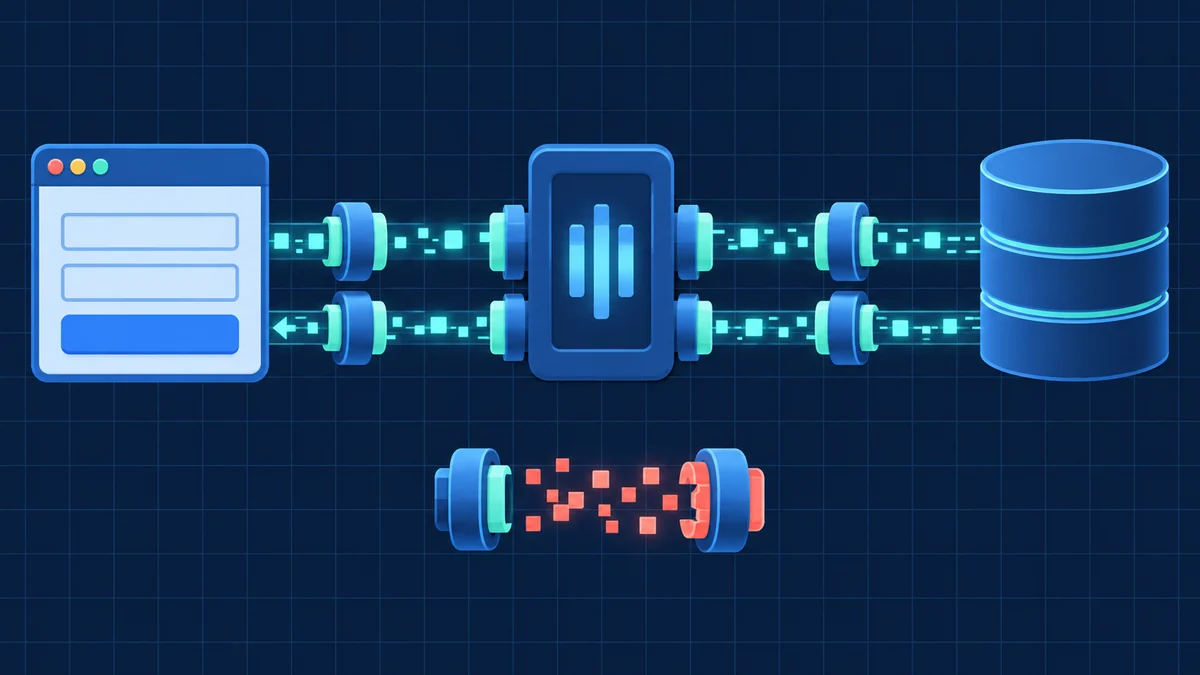
UTF-8 선언은 필요하지만 충분하지 않다
HTML에는 문자 인코딩을 선언하고, HTTP 응답의 Content-Type도 실제 바이트와 일치시킵니다. API의 JSON은 라이브러리의 직렬화 설정과 중간 프록시의 응답 헤더를 확인합니다. 파일을 UTF-8로 변환하지 않고 선언만 바꾸면 문제가 더 헷갈립니다. W3C 국제화 체크리스트는 콘텐츠와 데이터베이스에 UTF-8을 사용하고 인코딩을 선언하며, 폼과 서버가 같은 체계를 사용하도록 권고합니다.
깨진 데이터가 이미 발행됐다면 원본 초안, 백업, 버전 기록 또는 작성자가 보관한 텍스트에서 복원해야 합니다. ‘??’가 들어간 현재 DB 값을 재인코딩하는 것만으로는 원래 문자를 추정할 수 없습니다. 복원 전에는 어느 시점부터 손실됐는지와 영향 받은 레코드를 먼저 확인해 다른 정상 데이터를 덮어쓰지 않도록 합니다.
다국어는 인코딩 다음 단계다
글자가 보이는 것과 사용자가 이해하기 쉬운 것은 별개입니다. 날짜, 시간대, 천 단위 구분, 통화, 주소와 이름 순서는 지역 설정에 따라 달라집니다. 원본에는 명확한 시각과 통화 단위를 저장하고 화면에서 로케일에 맞게 표현합니다. 임의의 문자열을 DB에 붙여 저장하면 정렬이나 계산이 어려워집니다. Unicode의 CLDR 프로젝트는 여러 언어·지역의 표시 데이터를 제공합니다.
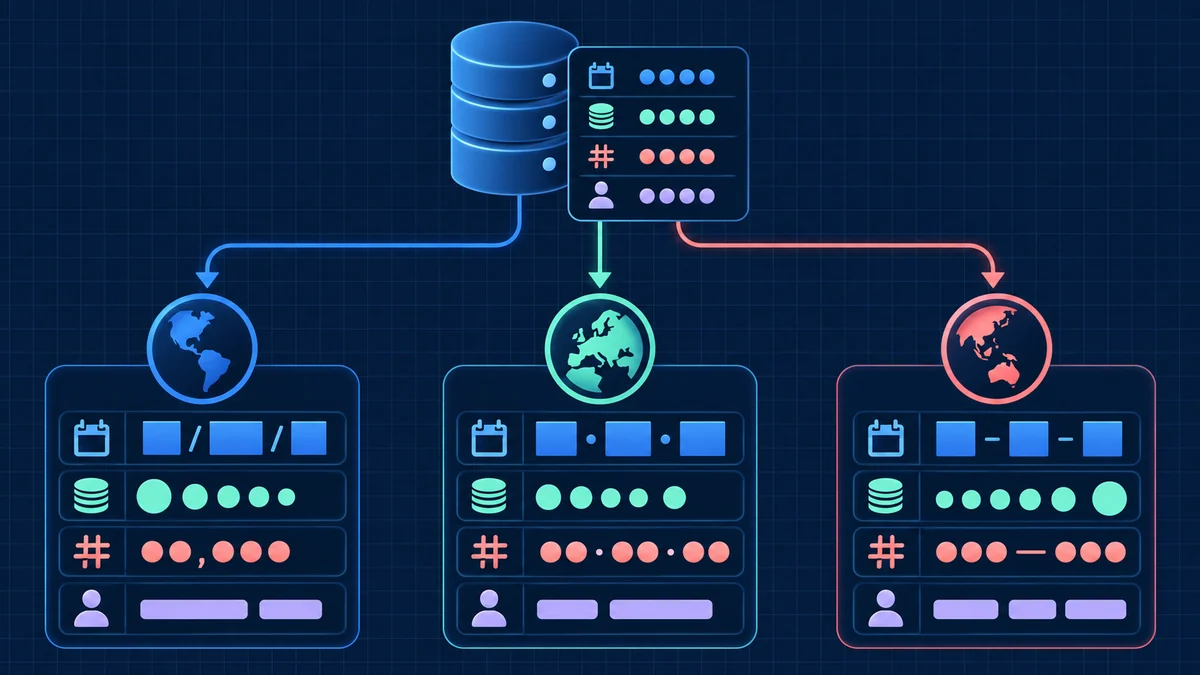
발행 전 자동 확인에 넣을 것
- 테스트 문자열이 입력·DB·응답·화면에서 같게 유지되는가?
- 제목뿐 아니라 본문, 카테고리, 태그, 메타 설명도 확인했는가?
- 공개 페이지와 관리자 화면의 한글을 모두 확인했는가?
- 백업에서 한글을 실제로 복원해 본 적이 있는가?
한글 깨짐은 작은 표시 오류처럼 보여도 검색 노출과 고객 신뢰까지 흔듭니다. ‘UTF-8 사용’이라는 한 줄 설정이 아니라 데이터가 지나는 모든 경계의 계약으로 관리해야 합니다.
#UTF8 #한글깨짐 #문자인코딩 #웹국제화 #다국어지원 #데이터베이스 #로케일 #웹개발 #데이터품질 #한글웹사이트