사내 문서를 찾아 답하는 AI, 설비 점검 보고서를 요약하는 AI, 고객 문의 초안을 쓰는 AI를 만들었다고 가정해 보자. 시험 화면에서는 잘 작동한다. 그런데 실제 직원들이 동시에 쓰기 시작하자 이런 반응이 나온다. “첫 문장이 나오기까지 너무 오래 걸린다.” “처음은 빠른데 답변이 한 글자씩 늦게 나온다.” “평소엔 괜찮은데 오전 9시만 되면 멈춘다.”
세 불만은 모두 ‘느리다’로 표현되지만 원인은 다를 수 있다. 첫 번째는 요청 대기 또는 입력 처리, 두 번째는 생성 단계, 세 번째는 동시 사용량과 대기열일 가능성이 높다. 이들을 하나의 평균 응답 시간으로 뭉치면, 서버를 늘려도 체감 속도가 바뀌지 않는 일이 생긴다. 이번 글은 LLM 추론의 시간을 해부하고, 기업 AI 운영에서 어느 지점을 먼저 고쳐야 하는지 살펴본다.
한 번의 답변에는 서로 다른 시계가 돌아간다
LLM 요청은 대체로 네트워크·인증 → 대기열 → 입력 프롬프트 처리(prefill) → 첫 토큰 → 후속 토큰 생성(decode) → 완료의 흐름을 지난다. 검색증강생성(RAG) 서비스라면 그 앞에 질의 변환, 검색, 재정렬, 문서 조립이 더해진다. 따라서 ‘모델이 느리다’는 진단을 내리기 전에 모델 밖의 시간을 떼어 내야 한다.
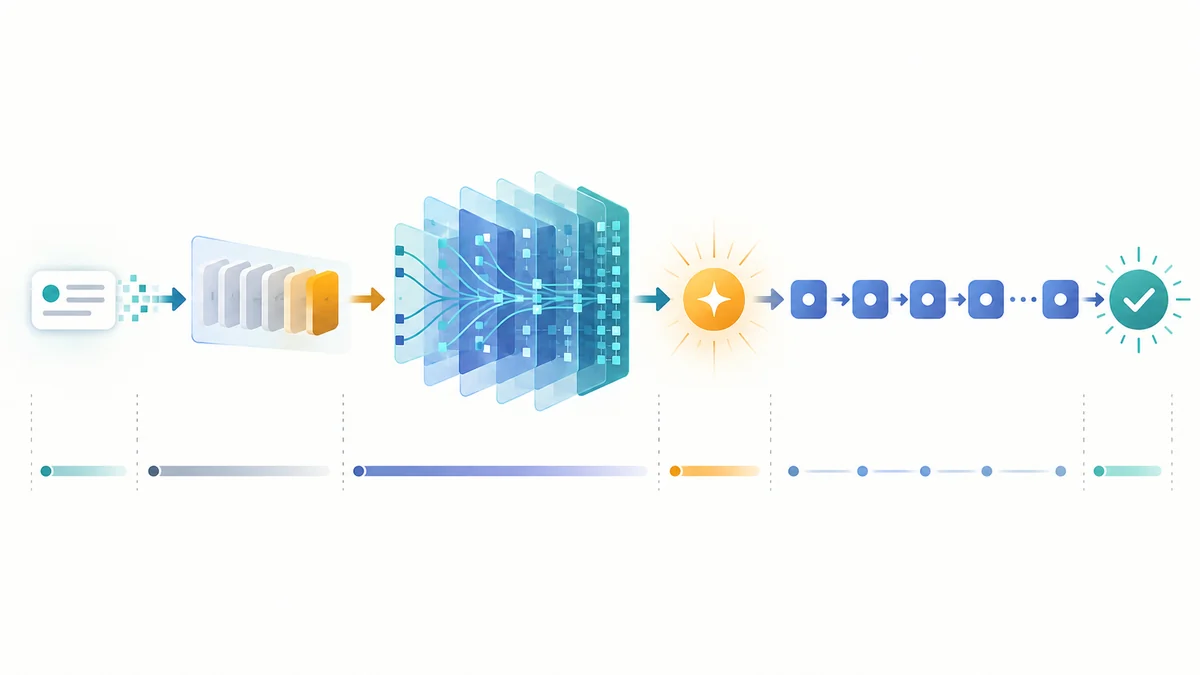
실무에서 최소한 다음 네 가지를 구분하면 좋다. TTFT(Time to First Token)는 요청을 보낸 뒤 첫 토큰을 받기까지의 시간이다. ITL(Inter-Token Latency)은 연속된 출력 토큰 사이의 간격이며, TPOT(Time Per Output Token)은 보통 첫 토큰 이후 출력 토큰당 걸린 시간을 집계하는 지표다. E2E(End-to-End Latency)는 마지막 토큰까지 받은 전체 시간이다. 이름이 비슷해도 측정 위치와 집계 방식은 서빙 엔진마다 다르므로 계측 정의를 함께 저장해야 한다. vLLM 메트릭 문서는 요청 대기, prefill, decode와 이들 지표를 구분해 제공한다.
예컨대 화면에 첫 글자가 빨리 뜨지만 긴 문장이 천천히 흐른다면 TTFT보다 생성 속도와 출력 길이가 문제일 수 있다. 반대로 출력 자체는 빠르지만 첫 글자까지 침묵이 길다면 대기열, 긴 입력 문맥, RAG 파이프라인을 의심해야 한다. 평균만 보지 말고 p50과 p95를 함께 본다. 소수의 긴 요청이 다른 사용자의 대기시간까지 밀어 올리는 현상은 평균에 잘 드러나지 않는다.
입력을 읽는 시간과 답을 쓰는 시간은 성격이 다르다
Prefill은 입력 토큰 전체를 처리해 이후 생성에 필요한 상태를 만든다. 길게 붙인 검색 문서, 시스템 지침, 대화 이력이 길어질수록 이 구간의 부담이 커진다. Decode는 앞서 만든 상태와 이전 출력에 의존해 다음 토큰을 순차적으로 만든다. 그러므로 “입력을 줄이는 일”과 “출력 생성을 빠르게 하는 일”은 서로 다른 최적화다.
기업 RAG에서 흔한 상황은 검색 결과를 안전하게 보이려고 문서 20개를 통째로 붙이는 것이다. 모델이 참고할 내용은 많아지지만, 사용자는 첫 답을 더 오래 기다린다. 먼저 확인할 것은 더 큰 GPU가 아니라 정말 필요한 근거만 들어가는지다. 검색 상위 문서의 중복 제거, 의미 있는 구간 선택, 표의 관련 행만 추출, 긴 대화 요약, 명확한 출력 형식은 TTFT와 비용을 동시에 줄일 여지가 있다. 다만 문맥을 무작정 자르면 근거 누락과 환각이 늘 수 있으므로 정확도 평가와 묶어서 실험해야 한다.
또 하나의 함정은 출력 토큰 수다. 짧은 “예/아니오 + 근거 링크”와 2,000자 보고서는 같은 지연 목표로 운영할 수 없다. 답변 길이의 상한, 간결한 기본 응답, 필요할 때만 상세 설명을 확장하는 UX는 decode 부담을 줄인다. 기술적 성능 튜닝과 제품 설계가 분리되지 않는 이유다.
스트리밍은 빠른 계산이 아니라 빠른 전달이다
스트리밍은 생성된 토큰을 완료 시점까지 모아 두지 않고 바로 전달한다. 사용자는 모델이 작업 중임을 확인할 수 있어 체감 대기시간이 줄어든다. 하지만 일반적으로 마지막 토큰까지 생성하는 총시간 자체를 줄이지는 않는다. Hugging Face의 TGI 스트리밍 설명도 이 차이를 명확히 구분한다.
따라서 스트리밍을 켠 뒤에는 ‘로딩 화면이 사라졌는가’뿐 아니라 실제 TTFT, 마지막 토큰 도착시간, 중간 전송 간격을 따로 봐야 한다. 프록시나 브라우저가 응답을 버퍼링하면 서버는 스트리밍 중이어도 사용자는 아무것도 보지 못한다. 반대로 첫 토큰이 빠르게 보여도 근거 확인이 끝나지 않은 내용을 너무 일찍 확정적으로 표시하면 신뢰 문제가 생긴다. 업무용 AI라면 진행 상태와 임시 답변의 성격을 UI에 분명히 표시하는 편이 안전하다.
KV 캐시는 무엇을 재사용하고, 무엇을 못 줄이나
LLM은 이전 토큰의 attention 계산에 필요한 키·값(KV) 상태를 유지하며 후속 토큰을 생성한다. 여러 요청의 앞부분이 정확히 같다면, prefix caching은 이미 계산한 공통 접두 구간의 KV 블록을 재사용해 그 구간의 prefill을 줄일 수 있다. 예를 들어 동일한 시스템 지침과 동일한 정적 정책 문서를 수많은 요청이 공유한다면 유리하다. vLLM의 자동 prefix caching 설계 문서는 공통 prefix의 KV 블록 재사용을 설명한다.
그러나 세 가지 단서가 있다. 첫째, 문서 순서나 앞부분의 작은 변경으로도 공유 가능한 prefix가 줄어든다. 둘째, 사용자별로 다른 내용은 공유 이득이 작다. 셋째, 이 방식은 주로 반복된 입력 구간의 계산을 아끼지, 새로운 답변을 한 토큰씩 생성하는 decode 자체를 마법처럼 없애지 않는다. 캐시 적중률만 올리려다 사용자별 권한이 다른 문서를 공통 프롬프트에 섞으면 안 된다.
특히 여러 고객사가 같은 모델 인스턴스를 쓰는 환경에서는 성능뿐 아니라 격리 경계가 중요하다. 공유 prefix 캐시의 타이밍 차이가 정보 단서가 될 수 있어, vLLM 보안 문서는 cache_salt를 통한 격리 방식을 안내한다. 캐시 키와 테넌트 경계, 민감 정보의 위치를 함께 설계해야 한다. vLLM 보안 문서도 이 위험을 명시한다.
동시 요청을 묶을수록 항상 좋아지는 것은 아니다
GPU를 한 요청만 위해 쓰면 빈 연산 자원이 생기기 쉽다. 연속 배치(continuous batching)는 진행 중인 요청이 끝나기를 기다리지 않고 새 요청을 배치에 넣어 처리량을 높인다. 서비스 이용자가 많은 시간대에는 특히 유용하다. 하지만 배치 크기를 크게 잡으면 긴 입력 요청이 들어왔을 때 다른 요청의 토큰 생성이 밀리거나, KV 캐시 메모리가 포화되어 대기열이 길어질 수 있다. 처리량 개선과 p95 지연 개선은 같은 목표가 아니다.
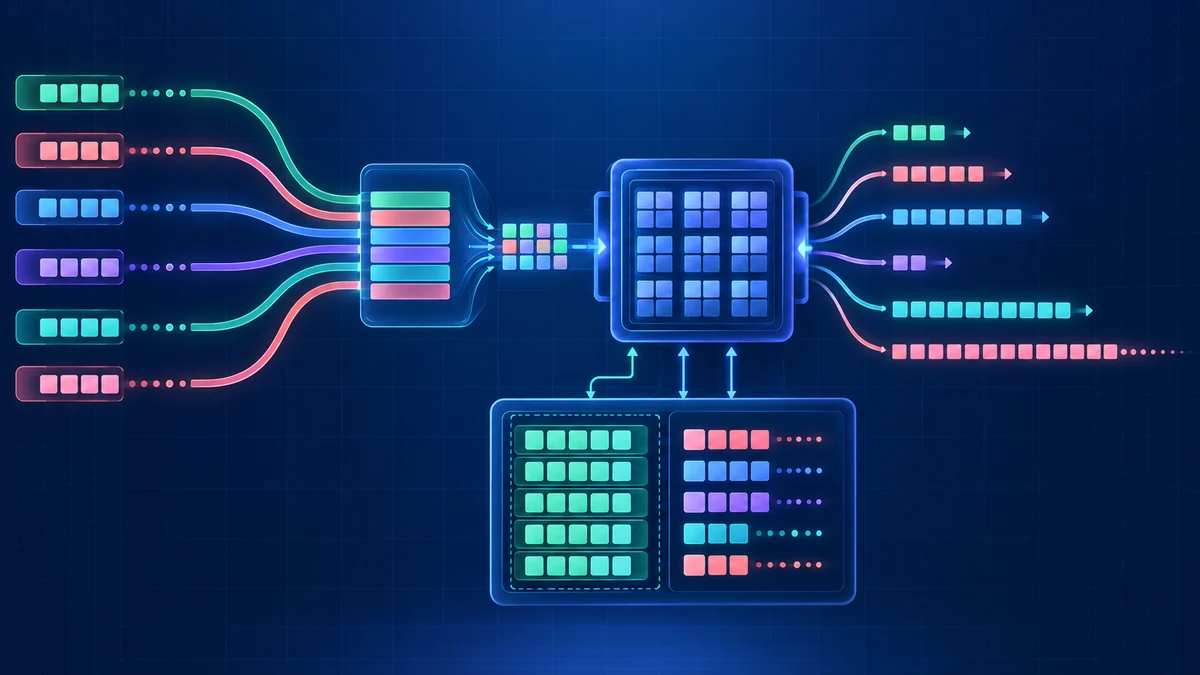
긴 prefill이 짧은 decode 요청을 가로막는다면 chunked prefill처럼 입력 처리를 여러 조각으로 나눠 decode와 함께 스케줄링하는 방법을 고려할 수 있다. 단, 설정에 따라 TTFT와 ITL의 균형이 바뀌므로 실제 요청 분포에서 비교해야 한다. vLLM 최적화 문서는 배치 토큰 한도와 chunked prefill의 지연·처리량 트레이드오프를 설명한다.
벤치마크는 ‘우리 요청’으로 해야 한다
공개 벤치마크의 초당 토큰 수 하나로 사내 서비스를 예측하기 어렵다. 상담 봇과 보고서 생성기는 입력·출력 길이도, 동시성도, 허용 가능한 대기시간도 다르다. 실험 부하에 실제 서비스의 입력 토큰 길이 분포, 출력 길이 분포, 요청 도착 패턴, RAG 검색 시간, 캐시 적중 가능성을 반영해야 한다. 시험 데이터에 같은 질문만 반복하면 prefix cache 효과를 과대평가하기 쉽다.
우선 요청별로 request_id를 붙이고, 프론트엔드·API·검색·모델 서버의 타임라인을 연결한다. 개인정보가 있는 원문 프롬프트를 로그에 그대로 남기기보다 토큰 수, 단계별 시간, 모델과 버전, 캐시 적중 여부, 오류 코드를 기록한다. 최소 대시보드는 아래 정도면 출발할 수 있다.
| 지표 | 무엇을 알려 주나 | 함께 볼 것 |
|---|---|---|
| TTFT p50 / p95 | 첫 응답까지의 체감 대기 | 대기열, 입력 길이, 검색 시간 |
| ITL 또는 TPOT p50 / p95 | 답변이 흘러나오는 속도 | 동시 요청, 배치, 출력 길이 |
| E2E p50 / p95 | 업무가 끝나는 전체 시간 | 출력 상한, 스트리밍 완료 |
| 대기열 시간·길이 | 용량이 몰릴 때의 병목 | 시간대별 도착률, 오류율 |
| KV 캐시 사용량·prefix 적중 | 메모리 압박과 재사용 효과 | 테넌트 격리, 프롬프트 구조 |
TGI 메트릭 문서 역시 대기시간, 총시간, 입력·출력 길이, 배치 관련 지표를 제공한다. 어떤 엔진을 쓰든 측정 정의를 맞추고 변경 전후를 같은 부하에서 비교하는 것이 핵심이다.
현장에서 적용할 개선 순서
- 문제를 나눈다. “느림”을 첫 토큰 지연, 토큰 간 지연, 전체 완료 지연으로 분류하고 p95와 동시성을 기록한다.
- 모델 밖 시간을 분리한다. 검색·재정렬·권한 검사·네트워크·프록시 버퍼링이 시간을 쓰는지 확인한다.
- 입력과 출력을 다듬는다. 중복 근거를 줄이고 답변 길이와 형식을 업무 목적에 맞춘다. 품질 평가를 동시에 돌린다.
- 공유 가능한 정적 prefix를 정리한다. 테넌트 격리와 권한 경계를 먼저 정한 뒤 캐시 적중 및 TTFT를 비교한다.
- 배치·메모리·용량을 조정한다. 평균 처리량뿐 아니라 혼잡 시간의 대기열, p95, 실패율을 보고 설정을 정한다.
- 스트리밍 UX를 검증한다. 첫 글자가 빨리 보여도 전체 완료와 근거 표시가 업무에 적절한지 확인한다.
결국 LLM 추론 성능은 ‘GPU 한 장당 초당 몇 토큰’보다 특정 사용자가, 특정 업무에서, 필요한 근거를 포함한 답을 언제 받는가의 문제다. 느림의 원인을 단계별로 측정하면 투자 순서도 달라진다. 어떤 서비스에는 더 큰 모델 서버가 필요하지만, 어떤 서비스에는 검색 결과 20개를 5개로 줄이는 설계가 더 효과적일 수 있다. 기업 AI를 운영할 때 중요한 것은 가장 빠른 단일 숫자가 아니라 정확도·보안·비용·체감 지연 사이의 균형이다.
#LLM추론 #AI응답속도 #첫토큰지연 #TTFT #KV캐시 #PrefixCaching #연속배치 #ContinuousBatching #RAG성능 #AI서비스운영 #생성형AI #기업AI #AI아키텍처