학습 데이터에 예측 시점 이후의 정보를 섞지 않는 point-in-time 조인과 재현 가능한 피처 설계입니다.
왜 이 문제가 생길까
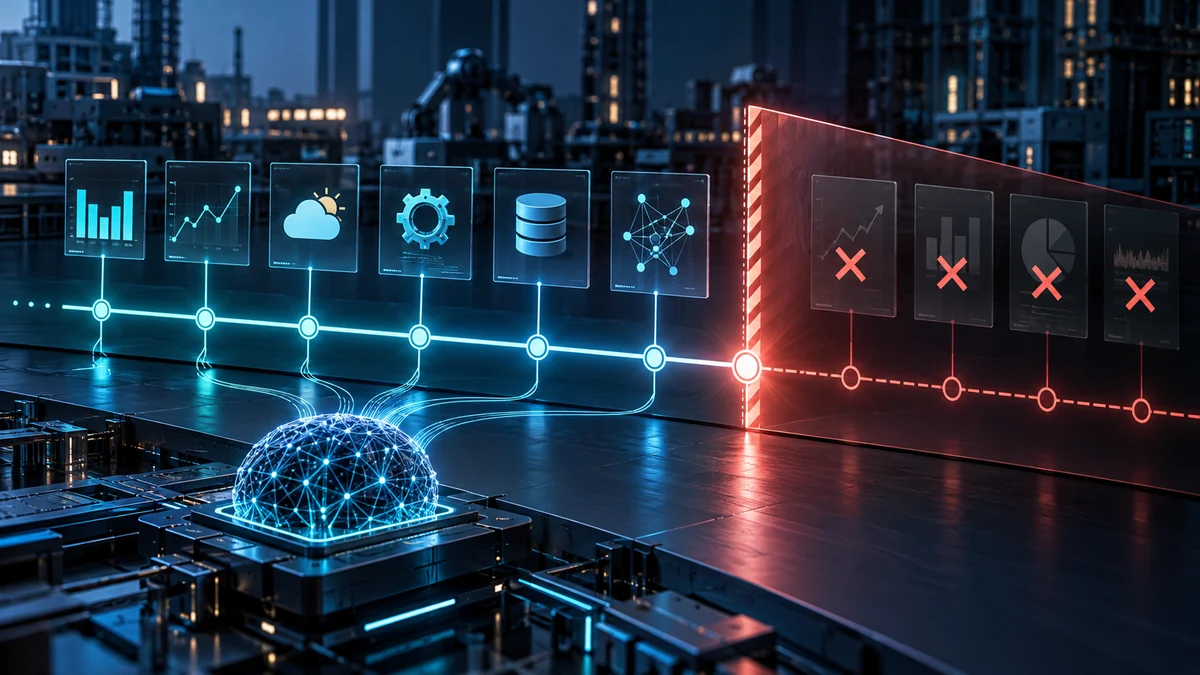
모델 학습 점수는 높은데 실제 운영에선 성능이 떨어질 때 미래 정보 누수를 의심해야 합니다. 예를 들어 지난달의 불량 예측 학습에 이번 달 정비 결과를 함께 붙이면 모델은 운영 시점에 알 수 없었던 답을 본 셈입니다. 테이블에 최신 값만 저장하면 이런 실수를 발견하기 어렵습니다.
시스템은 무엇을 구분해야 할까
각 예측 사례에 '그때 예측했을 시각'을 부여하고 피처는 그 시각 이전에 이용 가능했던 마지막 값만 조인합니다. 이벤트 발생 시각과 시스템에 도착한 시각을 구분해야 합니다. 센서값이 오전에 측정됐어도 오후에 처리됐다면 오전 예측에는 사용할 수 없기 때문입니다. 학습과 온라인 추론에서 동일한 피처 정의를 공유하고, 재계산을 위해 원천 이력과 정의 버전을 보존합니다.
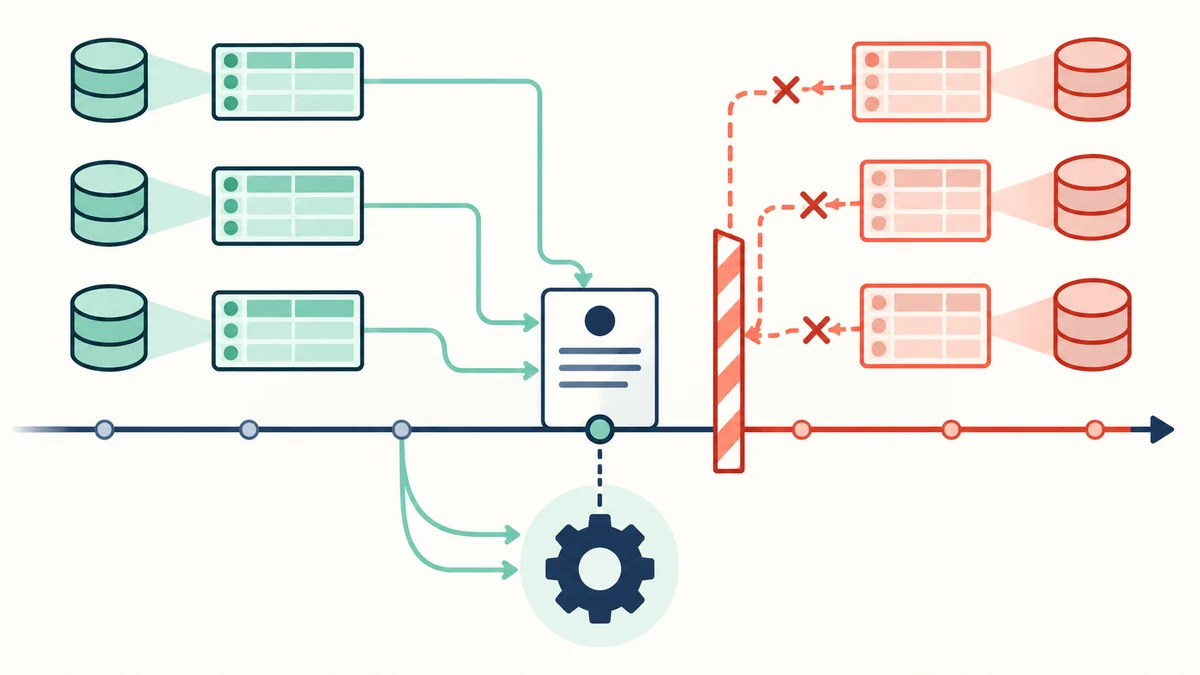
현장에서 적용하면
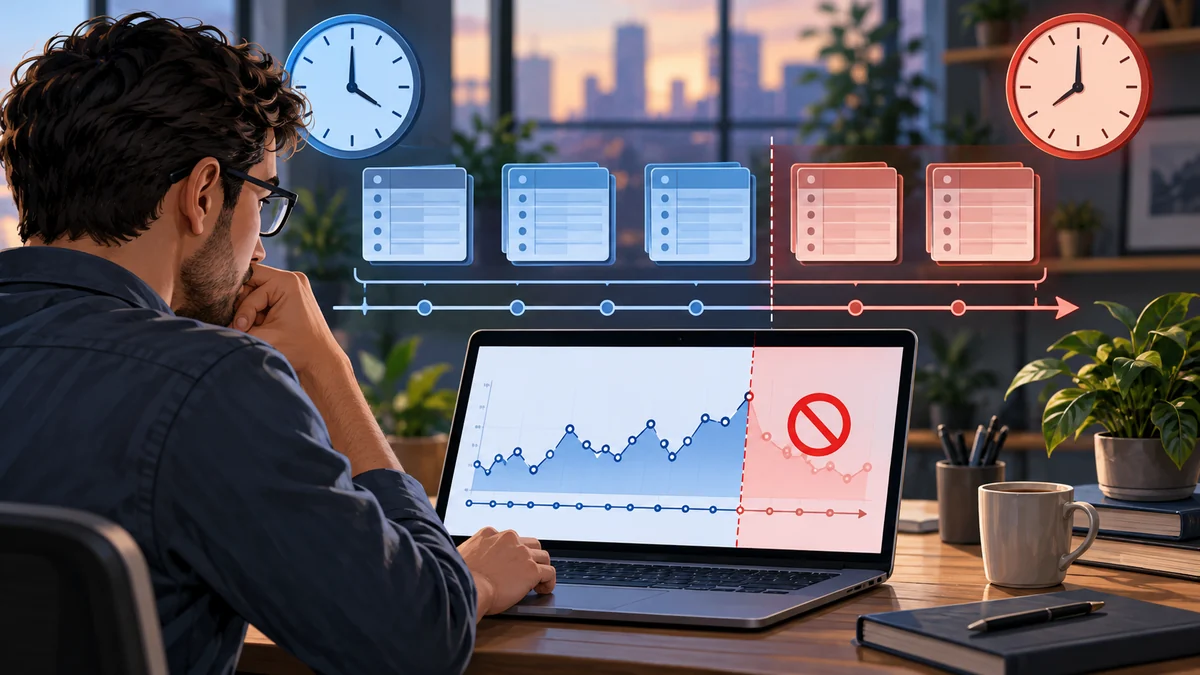
설비 고장을 하루 전에 예측하는 모델에서 정비 완료 코드는 강력한 예측 변수처럼 보일 수 있습니다. 그러나 실제 고장 이전에는 존재하지 않으므로 학습 시 제외해야 합니다. 특정 날짜의 예측을 재현해 당시 수집 완료된 데이터만 붙이는 테스트를 자동화하면 이런 누수를 잡는 데 도움이 됩니다.
도입할 때 놓치기 쉬운 점
단순히 이벤트 타임이 과거라는 이유만으로 안전하지 않습니다. 뒤늦게 수정된 값이나 사후 확정된 라벨도 누수가 됩니다. 오프라인 학습과 온라인 제공의 값 차이를 샘플링해 점검하고, 누수 위험 피처는 생성 경로를 문서화해야 합니다.
시작 전 점검할 세 가지
- 예측 시각과 데이터 이용 가능 시각을 구분하는가
- 과거 시점의 피처 값을 재현할 수 있는가
- 학습·운영 피처 차이를 주기적으로 비교하는가
참고 자료: Feast의 과거 시점 피처 조회 개념
#피처스토어 #머신러닝 #데이터누수 #시점조인 #MLOps #예측모델 #학습데이터 #시계열 #AI운영 #데이터엔지니어링