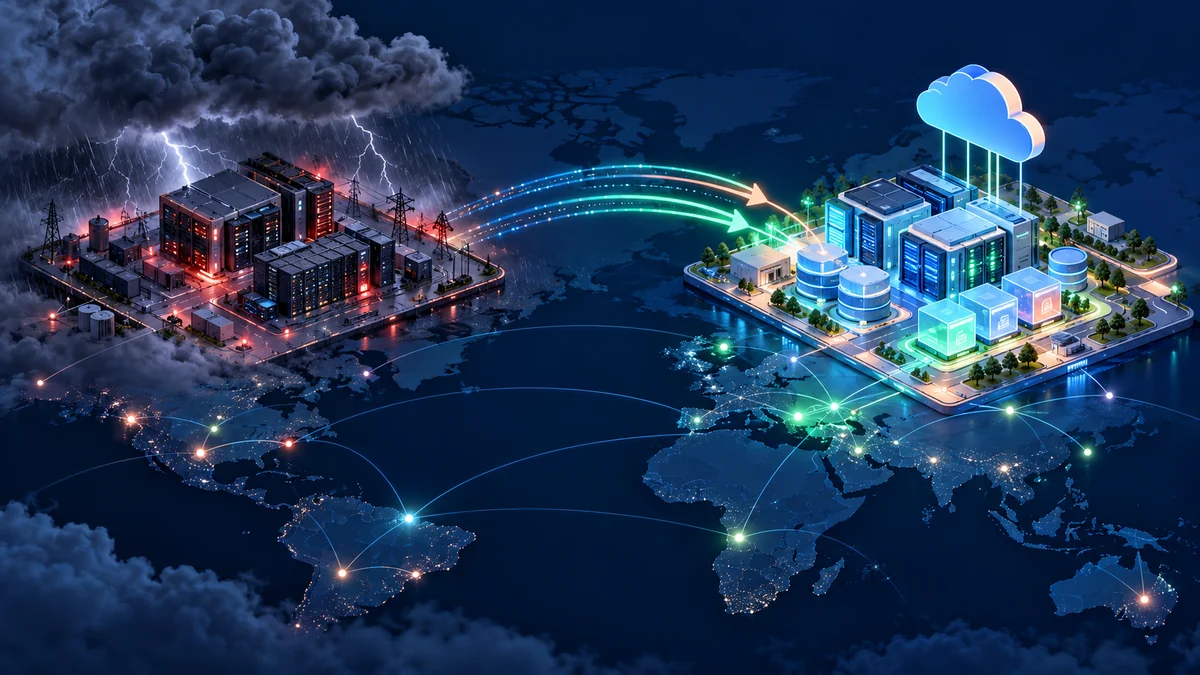
“백업은 매일 하고 있으니 큰 장애가 나도 금방 복구됩니다.” 이 말에는 중요한 빈칸이 있습니다. 백업 파일을 가져와 데이터베이스에 복원하는 것과 고객이 다른 지역에서 로그인해 핵심 업무를 다시 처리하는 것은 전혀 다른 일입니다. 애플리케이션 이미지, 비밀 정보, DNS, 외부 연동, 파일 저장소, 배치 작업, 메일 발송까지 함께 동작해야 서비스가 돌아왔다고 말할 수 있습니다. 재해 복구 훈련은 그 빈칸을 실제로 확인하는 과정입니다.
복구 목표부터 업무 언어로 정한다
RTO는 서비스 중단 뒤 허용할 수 있는 복구 시간이고, RPO는 복구 시점에서 감수할 수 있는 데이터 손실 범위입니다. AWS Well-Architected 지침도 두 목표를 비즈니스가 먼저 정하고 기술 전략을 선택하는 기준으로 사용하라고 설명합니다. 모든 기능에 같은 목표를 붙일 필요는 없습니다. 주문 접수는 30분 안에 복구되어야 하지만 내부 통계 대시보드는 다음 날까지 허용될 수 있습니다. 반대로 이미 접수된 주문의 손실은 몇 분도 허용하기 어려울 수 있습니다.
목표를 정했다면 실제 구성과 비교합니다. 하루에 한 번 백업하면서 RPO를 5분으로 약속할 수는 없습니다. 복구 지역에 서버를 새로 만들어야 하는데 RTO를 10분이라고 적는 것도 현실적이지 않습니다. 백업·복원, 최소 핵심 자원만 유지하는 pilot light, 축소 운영 상태를 유지하는 warm standby 등은 비용과 복구 시간의 교환 관계가 있습니다. 높은 가용성 전략일수록 데이터 충돌과 운영 복잡성도 커집니다.
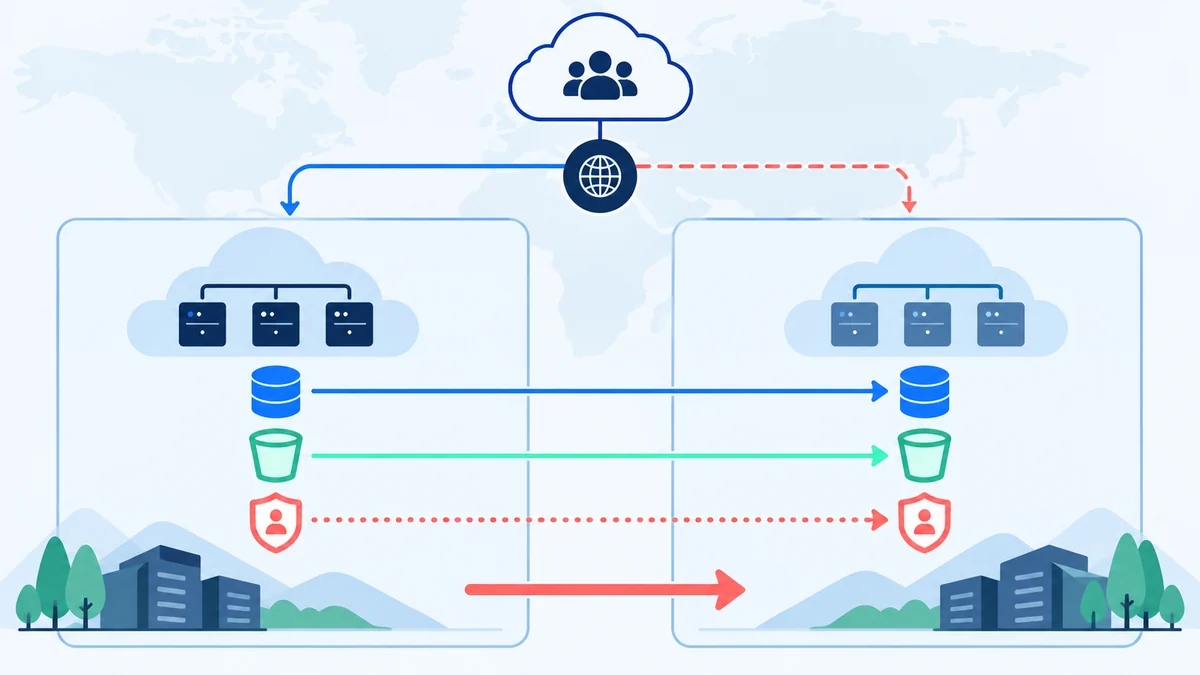
전환 때 가장 위험한 것은 이중 쓰기다
주 지역이 완전히 죽었다고 생각했는데 일부 사용자는 여전히 그쪽에 연결될 수 있습니다. 그 상태에서 복구 지역도 쓰기를 받으면 두 데이터가 갈라집니다. 전환 절차에는 주 지역의 쓰기를 막는 조건, 복제 지연 확인, 복구 지역의 마지막 일관된 지점 선정, 트래픽 전환 순서가 있어야 합니다. DNS 설정만 바꾸면 모든 기존 연결이 즉시 이동하는 것도 아닙니다. 클라이언트 캐시, 장기 연결, 외부 시스템의 고정 IP 등 실제 경로를 확인해야 합니다.
또 하나의 함정은 배치와 알림입니다. 복구 지역에서 서비스가 시작되면서 예약 작업이 두 지역에서 동시에 돌거나, 지난 시간의 알림이 한꺼번에 발송될 수 있습니다. 전환 전후에는 실행 권한의 소유 지역을 명확히 하고, 작업별로 재시작·보충·취소 기준을 둡니다. 고객에게는 단순히 “복구 완료”라고 알리기 전에 로그인, 조회, 저장, 외부 연동의 대표 여정을 실제로 검증해야 합니다.
의존 서비스가 복구 지역에서 정말 사용 가능한지도 목록으로 확인합니다. 같은 클라우드 계정이라도 리전별 서비스 할당량과 이미지 저장소, 암호화 키, 도메인 인증서가 다를 수 있습니다. 원래 지역에만 둔 관리 콘솔이나 비밀 저장소에 접속해야 전환할 수 있다면 장애 상황에서 절차가 멈출 수 있습니다. 훈련 전에 “주 지역 없이도 누가 어떤 자격으로 복구를 시작할 수 있는가”를 점검하는 이유입니다. 이 단계가 빠지면 가장 잘 만든 복제본도 켜지지 않습니다.
훈련은 전체 서비스 차단만 의미하지 않는다
처음에는 격리된 복구 환경에서 백업을 복원하고 대표 데이터를 읽어 보는 것부터 시작할 수 있습니다. 다음으로 운영과 동일한 설정·비밀 접근 경로로 앱을 띄우고, 제한된 테스트 계정만 복구 지역에 연결해 사용자 여정을 확인합니다. 마지막으로 계획된 시간에 트래픽 전환을 연습할 수 있습니다. 어떤 수준이든 실제 시작·종료 시각, 데이터 복제 지연, 수동 단계, 실패 원인을 기록해야 합니다. AWS의 복구 테스트 지침 역시 정기적인 전환 시험으로 RTO와 RPO 충족 여부를 검증할 것을 권합니다.
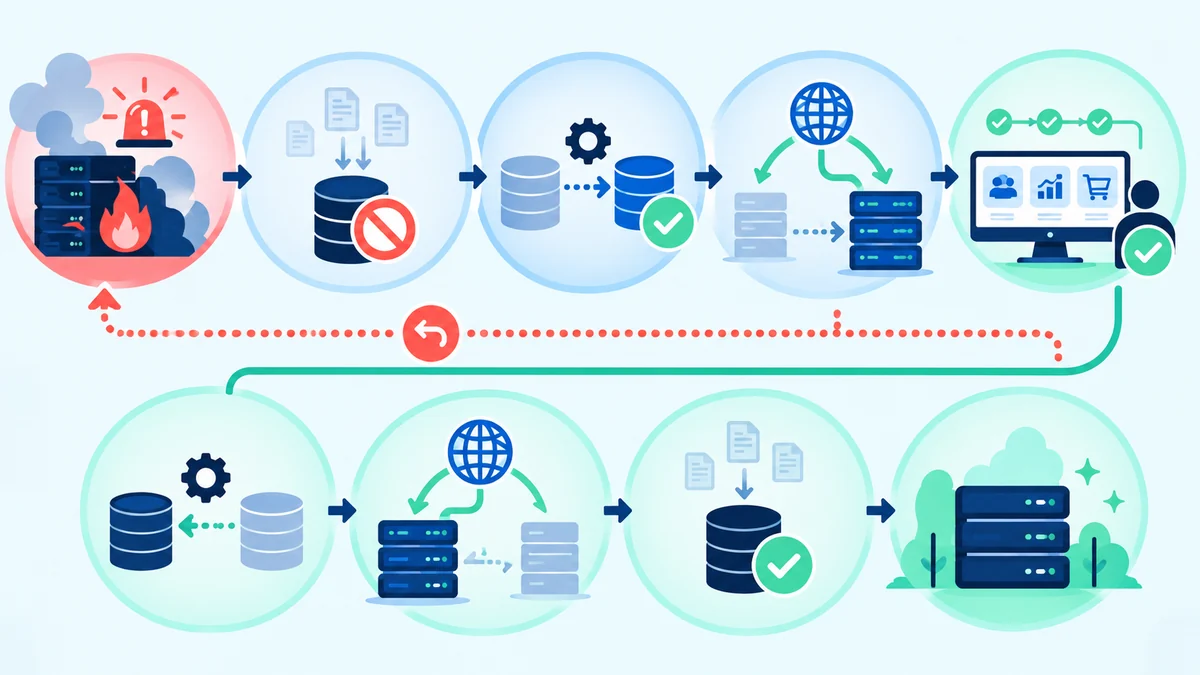
원래 지역으로 돌아가는 failback도 미리 설계해야 합니다. 복구 지역에서 새로 발생한 데이터를 어떻게 동기화하고, 어느 시점에 쓰기를 멈춘 뒤 다시 전환할지 결정해야 하기 때문입니다. 훈련 결과가 목표에 미달했다면 장비를 더 사기 전에 가장 오래 걸린 수동 단계와 숨은 의존성을 찾아보세요. 복구 계획의 가치는 문서의 분량이 아니라 훈련에서 측정한 시간과 재현 가능한 절차로 판단할 수 있습니다.