RAG 평가에 답할 수 없는 질문을 넣어야 하는 이유
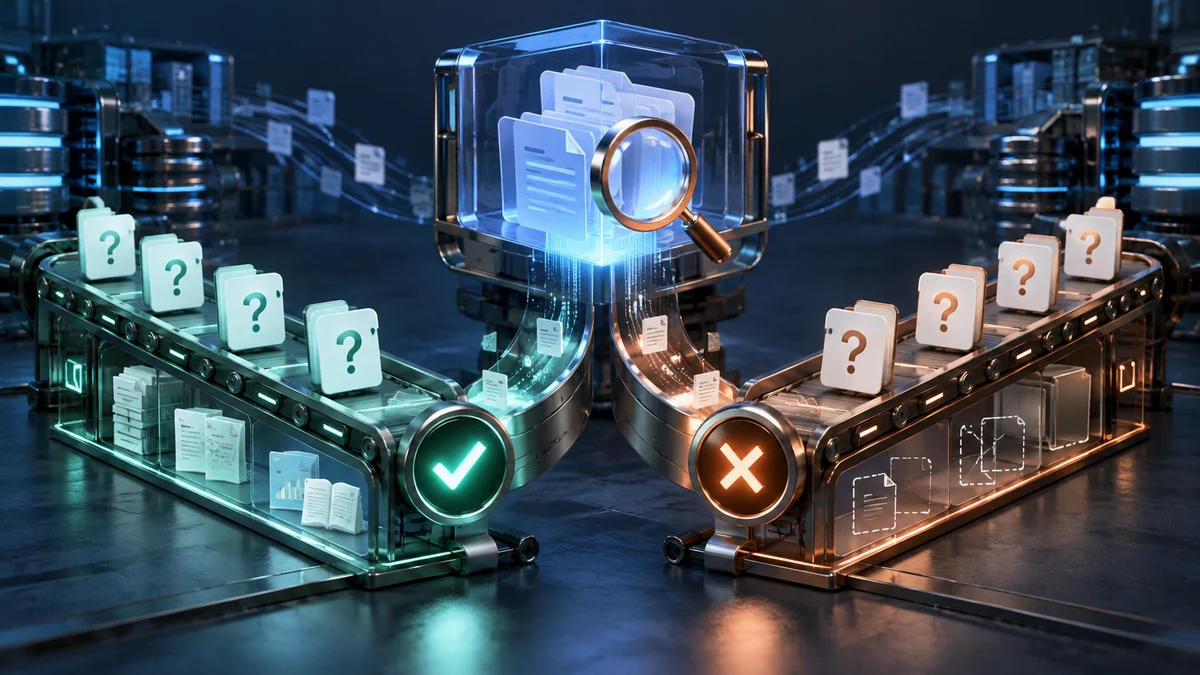
RAG 평가에 답이 있는 질문만 넣으면 시스템은 항상 무언가를 말하도록 학습됩니다. 실제 사용자는 아직 문서에 없는 정책, 권한 밖의 자료, 서로 충돌하는 규정을 묻습니다. 좋은 평가는 모른다고 해야 하는 상황을 포함합니다.
질문을 세 종류로 나눈다
근거가 충분한 질문, 근거가 없는 질문, 문서끼리 충돌하는 질문을 분리합니다. 같은 문서에도 적용 대상이 다른 경우를 넣습니다. 답변 가능 여부는 모델 점수보다 원문으로 확인 가능한 기준으로 라벨링합니다.
보류 응답도 정답으로 센다
근거가 없을 때 그럴듯한 답을 만드는 것은 실패입니다. 자료를 찾지 못했다고 말하고 필요한 문서나 담당자를 안내했다면 적절한 결과입니다. 보류율만 낮추면 거짓 답변이 늘 수 있으므로 지표를 따로 봅니다.
권한 질문을 조심한다
사용자에게 볼 권한이 없는 문서가 검색 색인에 있어도 답변에 사용하면 안 됩니다. 평가에는 서로 다른 권한의 계정으로 같은 질문을 묻는 사례를 넣습니다. 존재 자체가 민감한 자료는 거절 문구도 정보 노출을 막아야 합니다.
근거 단위로 오류를 찾는다
문단 전체에 출처 하나를 달면 일부 주장만 맞을 수 있습니다. 핵심 수치와 정책 문장별로 원문 구간을 확인합니다. 틀린 답이 검색 누락, 오래된 문서, 생성 단계의 추론 중 어디서 생겼는지 분리해야 고칠 수 있습니다.
문서 변화에 따라 평가 세트를 갱신한다
새 규정이 생기면 예전의 '답 없음' 질문이 답 가능한 질문이 됩니다. 문서 버전과 평가 정답의 날짜를 기록하고 정기적으로 검토합니다. 평가 점수의 변화가 모델 개선인지 문서 변화인지 설명 가능해야 합니다.
현장에 적용할 때의 순서
- 답 가능·불가·충돌 질문 분류
- 근거별 판정과 보류 평가
- 문서 변경 때 정답 갱신
주의할 실패: 답 있는 질문만 평가
관찰할 지표: 근거 없는 단정률과 보류 정확도
적용 전 체크리스트
- 답 없음·충돌·권한 제한 질문이 평가에 포함됐는가
- 근거 없는 단정과 적절한 보류를 구분하는가
- 평가 정답에 문서 버전·날짜가 있는가
참고 자료
NIST AI Risk Management Framework. AI 시스템을 실제 사용 조건에서 평가하고 위험을 관리한다는 관점을 참고했습니다. 질문 세트 구성은 글의 실무 제안입니다.
이미지와 도식은 이해를 돕기 위한 개념 시각화입니다. 특정 고객의 실제 설비·데이터·화면을 재현한 것이 아닙니다.
#RAG평가 #답변보류 #근거기반AI #생성형AI #환각방지 #기업검색 #문서권한 #AI평가세트 #지식베이스 #답변품질
이 주제를 실제 시스템으로 옮기려면 AI 알고리즘 개발 살펴보기