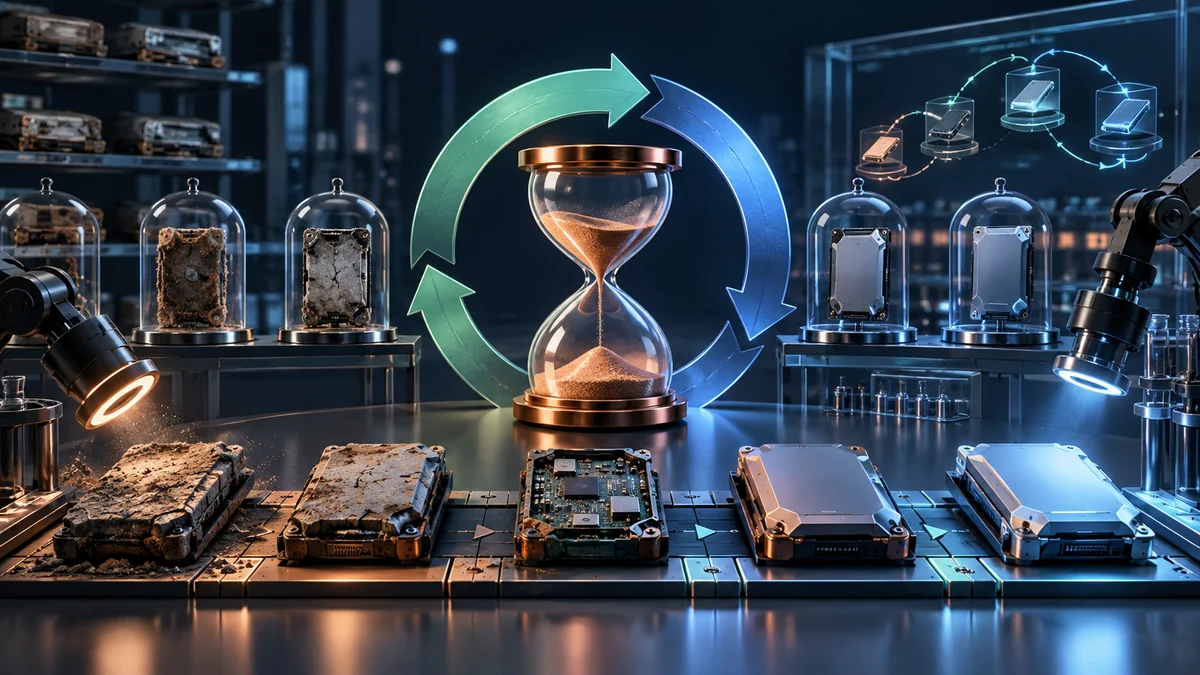
AI 평가용 정답 세트도 낡는다: 골든셋 갱신 기준
AI 평가에 쓰는 골든셋은 한번 정해 두면 영원한 정답일까요? 업무 양식, 제품군, 고객 질문이 바뀌면 평가 세트도 현실을 덜 대표하게 됩니다. 반대로 자주 바꾸면 성능 비교 기준이 흔들립니다. 고정과 갱신을 나누는 운영 규칙이 필요합니다.
NOTES
모델을 만들고, 웹과 앱을 짓고, 업무를 자동화하며 확인한 것을 기록합니다. 통한 방법만이 아니라 통하지 않았던 시도까지 남깁니다.
TOTAL 5 · AI 품질
AI 평가에 쓰는 골든셋은 한번 정해 두면 영원한 정답일까요? 업무 양식, 제품군, 고객 질문이 바뀌면 평가 세트도 현실을 덜 대표하게 됩니다. 반대로 자주 바꾸면 성능 비교 기준이 흔들립니다. 고정과 갱신을 나누는 운영 규칙이 필요합니다.
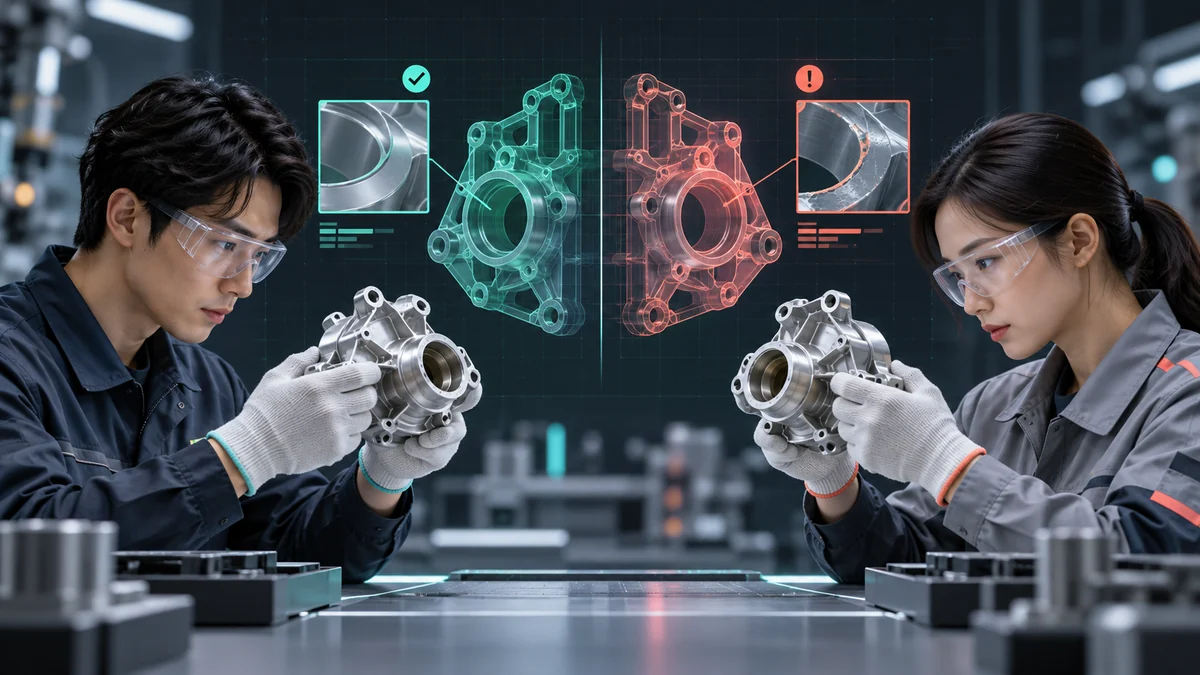
AI 검사 모델을 학습하려는데 같은 제품을 본 검사자 두 사람이 서로 다른 불량 라벨을 붙였습니다. 이런 사례를 한쪽의 실수로 바로 처리하면 모델의 기준도 불안정해집니다. 판정 차이가 생기는 조건을 기록하고 합의 과정을 설계해야 합니다.
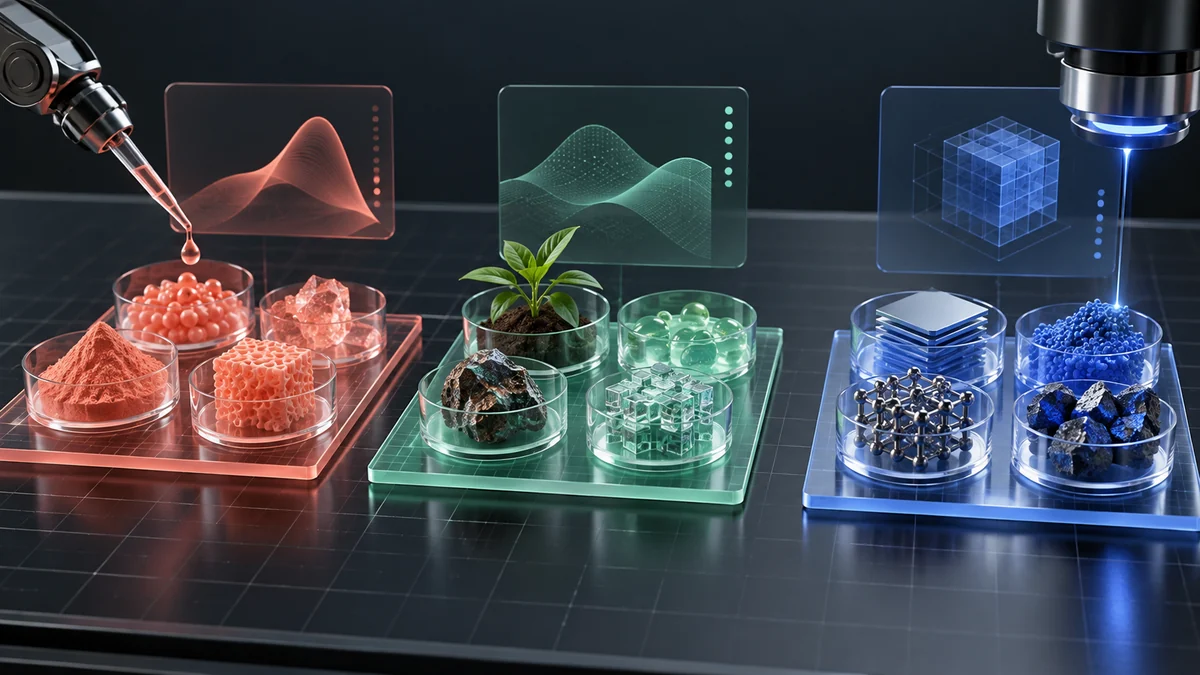
AI 답변 100개를 평가해 평균 점수가 올랐더라도 현장 문의만 나빠졌다면 출시하면 안 됩니다. 전체 평균은 자주 들어오는 쉬운 질문에 끌릴 수 있습니다. 평가 데이터를 실제 업무의 실패 비용에 맞춰 나누어야 변경의 의미가 보입니다.
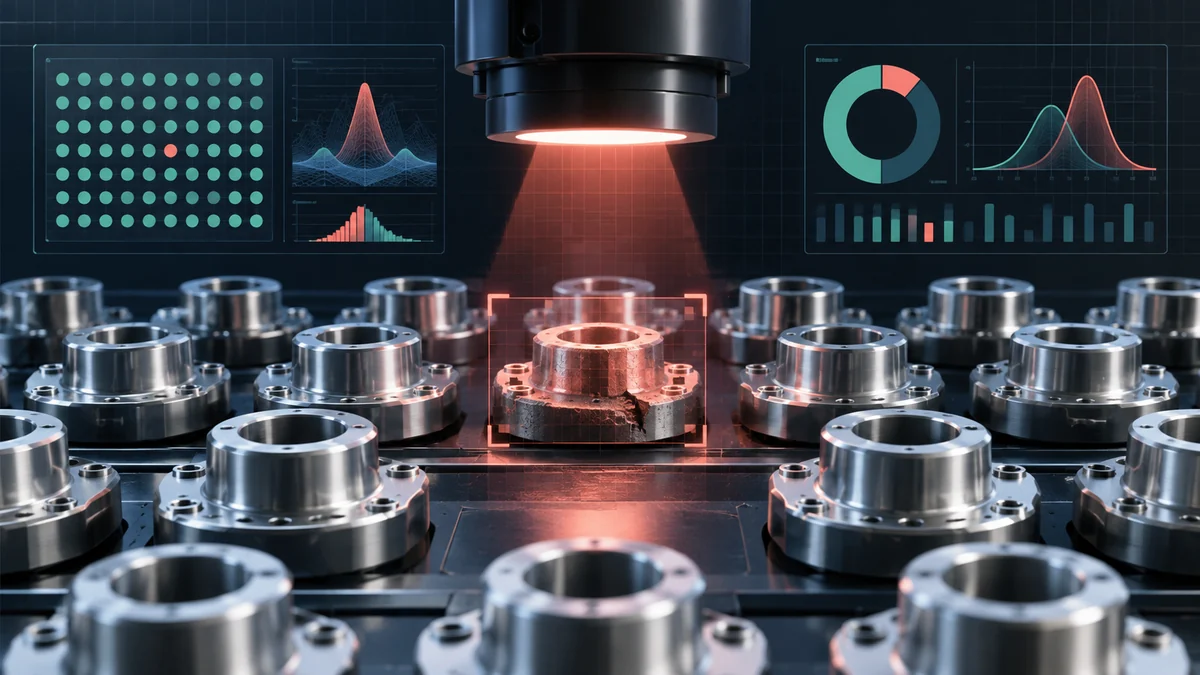
정상 제품이 대부분이면 전체 정확도만으로 검사 성능을 알기 어렵습니다. 놓친 불량과 잘못 배제한 정상품을 나눠 평가합니다.
자동 평가 점수가 올라도 실제 답변 품질이 좋아졌다고 단정할 수 없습니다. 순서·문체·평가 기준을 통제하는 실무 평가법입니다.